마케팅 담당자가 GEO 대시보드를 열었다. 이번 달 우리 도메인의 AI citation이 크게 늘었다. 회의에서는 좋은 소식으로 보고된다.
“ChatGPT에서 우리 콘텐츠가 많이 인용되고 있습니다.”
그런데 영업팀은 이상하다고 말한다. “왜 고객들은 경쟁사 이야기를 더 많이 하죠?”
둘 다 맞을 수 있다. 우리 사이트는 좋은 출처일 수 있다. 그렇다고 우리 브랜드가 좋은 추천 후보라는 뜻은 아니다.
핵심은 단순하다.
Citation, Mention, Recommendation, Accuracy, Conversion은 같은 일이 아니다.
KPI를 하나씩 분리해보자
먼저 지표를 단순하게 정리해보자.
Citation Share
정해진 질문 세트에서 우리 도메인이나 자료가 출처로 인용된 비율.
Mention Share
답변 본문에서 우리 브랜드·상품·장소의 이름이 언급된 비율.
Recommendation Share
추천을 요구하는 질문에서 우리 브랜드·상품·장소가 실제 추천 후보로 제시된 비율.
First-position Share
여러 추천 중 첫 번째 선택지로 제시된 비율.
Fidelity
우리 상품·서비스에 대한 설명이 원출처와 얼마나 충실하게 일치하는지. 이 뒤에 별도로 Referral과 Conversion이 붙는다.
이 용어들 가운데 일부는 업계나 연구에서 다양한 방식으로 쓰이고 있고, 하나의 국제 표준 정의로 고정된 상태는 아니다. 특히 Recommendation Share는 측정 규칙을 함께 제시해야 해석할 수 있다.
지표 이름보다 중요한 것은 서로 다른 사건을 한 숫자로 합치지 않는 것이다.
Citation Share가 높은데 Recommendation Share가 낮을 수 있다
노트북 비교 사이트를 운영한다고 해보자. 사이트에는 공식 사양을 잘 정리한 비교표가 있다. AI가 노트북 추천 질문에 답하면서 이 비교표를 자주 인용한다.
Citation Share는 높다. 그런데 추천되는 제품은 다른 회사 제품이다. 모순이 없다. 우리 사이트는 판단의 자료였고, 우리 브랜드는 판단의 대상이 아닐 수 있다.
심지어 브랜드 회사의 공식 사이트가 인용되면서도 최종 추천은 경쟁 제품이 될 수 있다.
둘은 분리해서 봐야 한다. 사이트 Citation Share가 높다고 그 사이트의 브랜드 Recommendation Share까지 반드시 높아지는 것은 아니다.1
이 지점에서 GEO 시장의 흔한 숫자 하나를 경계해야 한다. “우리 브랜드의 AI visibility가 72점입니다.”
그 72가 무엇인지 물어야 한다.
citation인가.
mention인가.
추천 위치인가.
몇 개의 질문을 썼는가.
브랜드명을 직접 넣은 질문도 포함되는가.
여러 번 반복했는가.
정의가 다르면 같은 숫자가 아니다.
Citation은 근거가 있다는 표시일 뿐, 안전 보증서가 아니다
그다음 문제는 정확성이다. AI 답변 옆에 출처 링크가 붙어 있으면 사람은 안심한다.
“적어도 출처가 있으니 맞겠지.”
하지만 5장에서 본 연구는 이 직관에 경고를 준다. 2023년 Liu, Zhang, Liang의 연구에서는 당시 생성형 검색엔진 답변의 문장 중 51.5%만 완전히 지지되었고, citation의 74.5%가 연결된 주장을 실제로 지원하는 것으로 평가됐다.2
2026년 CiteTrace는 훨씬 큰 규모의 분석에서 문제를 다른 방식으로 다시 확인했다. 10개 모델, 5개 제공자, 11,200개 질문과 112,000개 응답을 분석했을 때 citation pair의 30.6%가 원출처를 왜곡했고 27.1%는 질문에 대한 출처 도메인 적합성이 떨어지는 것으로 분류됐다.3
두 연구의 방법과 시대가 다르다. 수치를 직접 비교해 “정확성이 나빠졌다”거나 “좋아졌다”고 말할 수 없다.
그러나 공통된 결론은 분명하다. 인용이 있다는 이유만으로 설명이 안전하다고 가정할 수 없다.
Fidelity Gap — 이름은 맞는데 설명이 틀린다
여기서는 이 차이를 Fidelity Gap으로 다룬다. 인용 정확도, 근거 지지, 내용 흡수, 소스 충실도 연구에서 나타난 문제를 사업자가 점검하기 쉽게 묶은 이름이다.
예를 들어 AI가 한 호텔을 추천하며 이렇게 말한다고 하자. “조식이 무료이고 공항 셔틀을 24시간 제공합니다.”
호텔 이름은 맞다. 추천도 됐다. 그런데 현재 공식 정책을 보면 조식은 특정 요금제에만 포함되고, 공항 셔틀은 이미 중단됐다. 이 경우 Recommendation Share는 성공처럼 보이지만 Fidelity는 실패다.
전자제품이라면 더 위험하다.
이전 세대의 포트 구성을 현재 모델에 붙일 수 있다.
단종된 가격을 현재 가격처럼 말할 수 있다.
해외 사양과 한국 사양을 섞을 수 있다.
세무·의료·법률 분야에서는 오류 비용이 더 커진다. 그러므로 GEO 관리에서 “우리가 몇 번 나왔나” 다음에 반드시 물어야 한다.
“나왔을 때 제대로 설명됐나?”
출처를 선택하는 것과 내용을 흡수하는 것도 다르다
Citation Absorption 연구가 흥미로운 이유가 여기 있다. 어떤 자료가 citation으로 선택되는 과정과, 그 자료의 내용이 실제 생성문에 얼마나 흡수되는지를 따로 보려 했다.4
실무적으로 해석하면 이런 경우가 가능하다.
출처 링크에는 우리 사이트가 있다.
하지만 AI가 우리 사이트의 핵심 단서를 답변에 반영하지 않았다.
또는 반대도 가능하다. 우리 정보와 비슷한 내용이 답변에 들어갔지만 눈에 보이는 citation은 다른 출처다. citation만 세어서는 정보가 어떻게 전달됐는지 알 수 없다.
Citation pool에 있어도 최종 답변에는 안 나올 수 있다
2026년 중국어 생성형 검색엔진 연구는 4개 플랫폼의 Web/App 환경에서 614개 질문을 반복해 16만 건이 넘는 정리된 citation 기록을 분석했다. 이 연구에서 citation pool에 포함된 브랜드가 실제 답변 표면에서 선택되는 비율은 8.3%로 보고됐다.5
이 수치를 ChatGPT나 한국시장에 그대로 적용할 수는 없다. 하지만 우리가 5장에서 만든 파이프라인을 잘 보여준다.
citation pool
≠ answer selection
후보가 되는 것과 화면에 등장하는 것은 다르다.
추천됐는데 전환되지 않을 수도 있다
마지막 착각은 conversion이다. AI가 우리를 첫 번째로 추천했다. 그래서 매출이 올랐다고 생각한다.
하지만 중간에 여러 일이 있다.
사용자가 가격을 보고 포기할 수 있다.
Google 리뷰에서 나쁜 평판을 발견할 수 있다.
홈페이지가 느려 이탈할 수 있다.
재고가 없을 수 있다.
전화가 연결되지 않을 수 있다.
AI 안에서 비교를 마치고 아무 행동도 하지 않을 수 있다.
Conversion은 Citation이나 Mention에서 추론하지 않고 별도 행동데이터로 확인해야 한다.6
후반에서 추천 이후의 Verification Fork와 행동 데이터를 별도로 다루는 이유다.
GEO 대시보드를 다섯 칸으로 쪼개라
실무에서 가장 쉬운 변화는 대시보드다. 기존:
| 질문 | 우리 나옴? |
|---|---|
| Q1 | O |
| Q2 | X |
| Q3 | O |
이렇게 끝내지 않는다. 다음처럼 쪼갠다.
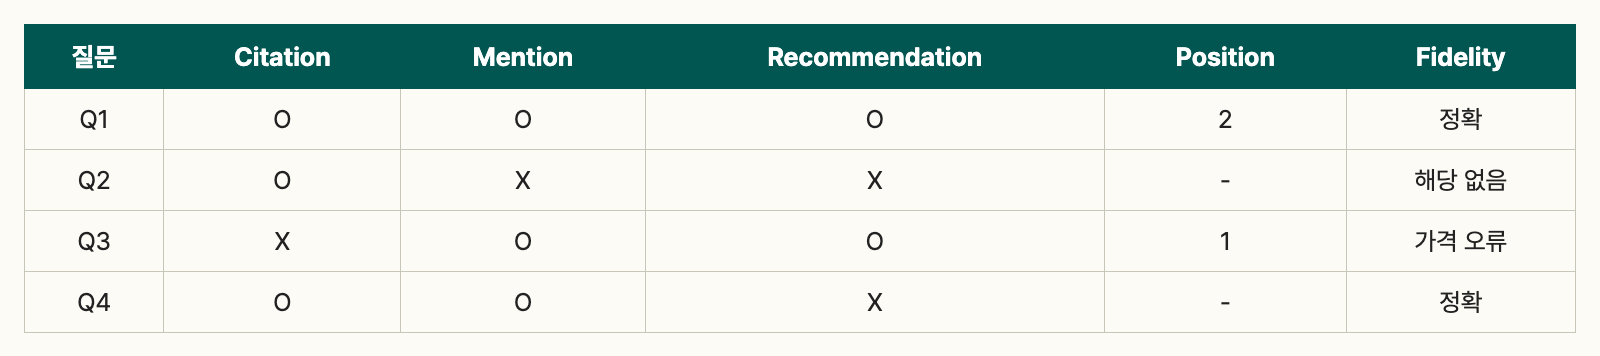
GEO 대시보드를 다섯 칸으로 쪼개라 표 양식
이 표만 있어도 진단이 달라진다. Q2는 좋은 정보원인데 브랜드가 노출되지 않는 문제일 수 있다. Q3는 추천은 잘 되지만 잘못된 설명이 퍼지는 문제다.
Q4는 언급은 되지만 최종 선택에서 밀린다. 각각 해결 방법이 다르다.
Fidelity Gap 점검표
AI가 우리를 설명한 답변을 하나 고른다. 그리고 원출처와 대조한다.
| 점검 | 확인 |
|---|---|
| 브랜드/상품명 정확 | |
| 가격 정확 | |
| 사양·서비스 범위 정확 | |
| 현재 운영정보 정확 | |
| 제한·예외조건 보존 | |
| 오래된 정보 혼입 없음 | |
| 다른 국가/모델 정보 혼합 없음 | |
| 출처가 실제 주장 지지 | |
| 과장·누락 없음 |
오류가 있으면 바로 “AI가 틀렸다”고 끝내지 않는다. 먼저 우리 정보환경도 본다.
공식 페이지가 오래됐는가.
서로 다른 페이지의 가격이 충돌하는가.
예전 블로그가 검색에 계속 남아 있는가.
제3자 사이트에 틀린 정보가 반복되는가.
AI 오류는 모델의 문제일 수도 있고, 웹에 존재하는 Evidence의 충돌에서 시작됐을 수도 있다. 물론 사업자가 모든 오류를 고칠 수는 없다.
하지만 자신이 통제할 수 있는 정보의 일관성은 관리할 수 있다.
‘추천됨’보다 ‘정확하게 추천됨’
4장에서는 AI가 안다고 추천하는 것은 아니라고 했다. 8장에서는 한 걸음 더 간다.
추천 사실만으로 설명의 정확성을 보장할 수 없다.
이 차이를 받아들이면 GEO의 목표가 바뀐다. 목표도 단순 노출 최대화에서 달라진다. 다음 세 가지를 함께 본다.
1. 맞는 질문에서 발견되는가
2. 맞는 사람에게 추천되는가
3. 그 이유를 정확하게 설명하는가
이 세 번째가 빠지면 GEO는 브랜드 언급 게임이 된다.
인용은 증거의 끝이 아니고, 추천은 정확성의 보증이 아니다.
이제 PART 2에서 필요한 네 조각이 갖춰졌다.
추천은 여러 단계를 거친다.
각 단계에서 필요한 Evidence가 다르다.
최종 선택은 사용자의 Context와 맞아야 한다.
그리고 추천됐을 때 설명의 Fidelity를 따로 봐야 한다.
한 장 지도의 QEAR로 되돌리면 이 네 조각이 곧 A, Answer Fit이다. 후보로 발견되는가. 이 사용자에게 실제로 맞는가. 그리고 정확하게 설명되는가. 이 세 질문에 답할 수 있어야 뒤에서 만들 Question Space와 Evidence가 실제 추천으로 이어진다.
다음 PART에서는 이 구조를 실제 사업에 적용한다. 첫 번째 작업은 키워드 목록을 만드는 것이 아니다. 우리 이름을 모르는 고객이 어떤 질문을 할 수 있는지, Question Space를 그리는 일이다.
1. Citation·Mention·Recommendation·Fidelity를 서로 다른 사건으로 분리하는 운영 구분. 생성형 검색의 citation support 연구, Citation Absorption, Discovery Gap, CiteTrace를 종합한 프레임이며 단일 업계 표준 KPI라고 주장하지 않는다. https://aclanthology.org/2023.findings-emnlp.467/ ; https://arxiv.org/abs/2604.25707 ; https://arxiv.org/abs/2601.00912 ; https://arxiv.org/abs/2605.28565
2. Liu, Zhang & Liang, Evaluating Verifiability in Generative Search Engines (2023), EMNLP Findings. 현재 플랫폼 정확도를 추정하는 수치가 아니라 citation ≠ verification의 구조적 근거로만 사용한다. https://aclanthology.org/2023.findings-emnlp.467/
3. Seo et al., Verified Misguidance / CiteTrace (2026), 프리프린트. Fidelity Gap은 이 연구의 정식 용어가 아니라 여기서 사용하는 실무 개념이다. https://arxiv.org/abs/2605.28565
4. Zhang, He & Yao, Citation Absorption (2026), 프리프린트. citation selection과 content absorption을 구분한다. https://arxiv.org/abs/2604.25707
5. Zhen et al., Chinese-language GSE citation audit (2026), 프리프린트. citation pool→answer selection 8.3%는 해당 중국어 플랫폼 표본에만 한정한다. https://arxiv.org/abs/2607.15771
6. Conversion은 Citation/Mention에서 추론하지 않고 별도 행동데이터로 측정해야 한다. Critical Survey와 From Prompt to Purchase가 downstream behavior와 answer visibility를 분리해야 함을 뒷받침한다. https://arxiv.org/abs/2607.14035 ; https://arxiv.org/abs/2606.10907