세무사를 찾는 사용자가 있다고 하자. 질문은 이렇다.
“전자책 인세가 조금씩 들어오고 있는데 이제 1인 출판사를 사업자로 등록하려고 한다. 아직 매출이 크지 않아 매달 기장료를 내는 게 맞는지 모르겠다. 사업자등록 전에 한 번 상담받을 곳을 찾고 싶다.”
이 질문에서 “친절한 세무사”라는 말만으로는 부족하다. 사용자가 판단하려면 더 구체적인 것이 필요하다.
초기 상담이 가능한가.
출판·콘텐츠 사업을 다뤄본 경험이 있는가.
면세와 과세 업무가 섞일 때 설명할 수 있는가.
당장 월 기장이 필요하지 않은 사람도 상담할 수 있는가.
상담 방식과 비용은 어떤가.
지역 방문이 필요한가, 비대면이 가능한가.
여기에서 사업자가 해야 할 일은 이 질문 문장을 그대로 홈페이지 제목으로 복사하는 것이 아니다. 질문 안에서 필요한 사실을 찾아내고, 그 사실이 어디에서 검증되는지 확인하는 것이다.
그 표를 Recommendation Evidence Map, 줄여서 Evidence Map이라고 부른다. 복잡한 GEO를 실제 업무로 옮기기 위한 실무 도구다.
증거가 많다고 좋은 것이 아니다
먼저 흔한 오해 하나를 버리자. “AI는 정보가 많을수록 좋아한다.”
반은 맞고 반은 위험하다. 관련 없는 정보를 길게 늘리는 것이 도움이 된다는 보편적 근거는 약하다. 2026년 여러 연구에서는 relevance, 즉 질문과 정보의 적합성이 반복적으로 강한 요소 중 하나로 나타난다.
What Gets Cited 연구는 6개 대규모 언어모델(LLM)을 대상으로 약 25만 회의 통제 실험을 수행했다. 두 문서를 경쟁시키는 조건에서 질문과의 관련성과 문서 위치가 강한 영향을 보였고, 가격이나 최신 날짜 같은 구체 정보가 일부 조건에서 도움이 된 반면 형식만 바꾸는 효과는 작거나 불안정했다.1
제한도 분명하다. 이 연구는 두 문서를 직접 주입한 통제 실험이다. 공개 웹 전체의 자연 검색을 그대로 재현한 것은 아니다.
“가격을 넣으면 GEO가 오른다”라고 쓰면 안 된다. 더 정확한 해석은 이렇다.
사용자의 결정에 필요한 구체 정보가 실제로 존재하는 것이, 단순한 형식 장식보다 더 중요한 방향으로 보인다.
Evidence Map은 여기에서 출발한다.
1. Owned Evidence — 내가 직접 책임지는 사실
첫 번째 층은 자사 정보다.
- 공식 웹사이트
- 서비스 설명
- 가격
- 이용조건
- FAQ
- 환불·취소
- 배송
- 상담 범위
- 지원 지역
- 공식 상품 사양
이 층은 화려함보다 정확성이 우선이다. 가령 세무사 홈페이지에 “1인 사업자 전문”이라고 크게 써 있지만 실제로 어떤 업종을 상담하는지, 초기사업자 상담이 가능한지, 비용은 어떻게 되는지 알 수 없다면 사용자의 상황 질문에 필요한 Evidence가 부족하다.
관광지에서도 원리는 같다. “춘천의 대표 문화공간”이라는 문장보다 가족 방문객에게는 운영시간, 어린이 프로그램, 휴관일, 주차, 예약 필요 여부가 더 결정적인 정보일 수 있다.
Owned Evidence의 핵심은 브랜드가 하고 싶은 말이 아니라 사용자가 결정할 때 필요한 사실이다.
2. Structured Evidence — 사람이 읽는 문장 밖의 데이터
두 번째는 구조화된 정보다. 상품이라면 특히 중요해진다.
- Product structured data
- Merchant feed
- 가격
- 재고
- 색상·용량 등 변형
- 예약 가능 상태
- 상품 식별자
여기에서 주의할 것은 “schema를 넣으면 ChatGPT 추천이 오른다” 같은 주장이다.
현재 근거만으로 Structured data가 모든 LLM의 브랜드 추천을 직접 상승시킨다고 말할 수는 없다. 공식적으로 지원되는 검색·상품 표면이 있는 것과 일반적인 AI 추천 확률을 올린다는 것은 다른 주장이다.2
반면 상품 discovery에서 product structured data와 merchant feed가 공식 지원되는 데이터 층이라는 점은 확인된다.
구조화 데이터는 이렇게 이해하는 편이 맞다. 추천을 보장하는 비밀 신호가 아니라, 시스템이 상품 사실을 정확하게 읽을 수 있도록 만드는 데이터 인프라다.
12장에서 상품 GEO를 다룰 때 다시 본다.
3. Local Evidence — 장소라는 사실
세 번째는 지역 정보다.
- 주소
- 지도
- 영업시간
- 전화번호
- 주차
- 예약
- 서비스 지역
- 지점
- 접근성
온라인 SaaS와 달리 식당, 병원, 학원, 관광지, 세무사, 호텔은 현실 공간에 있다.
사용자가 “지금 갈 수 있나”, “내 동선에 맞나”, “주차가 되나”라고 묻는 순간 콘텐츠의 문체보다 운영정보가 중요해진다.
춘천 여행 사례에서도 그렇다. “가족에게 좋은 문화공간”이라는 평가는 유용하지만, 식사 일정 사이에 넣으려면 운영시간과 위치가 필요하다.
이 정보는 사용자의 상황과 결합될 때 비로소 추천 판단에 쓰일 수 있다.
4. Earned Evidence — 내가 아닌 사람이 남긴 정보
네 번째는 제3자의 정보다.
- 언론 기사
- 비교 콘텐츠
- 리뷰
- 블로그
- 커뮤니티
- YouTube
- 전문 리뷰 사이트
GEO 업계에서는 종종 “Reddit이 제일 중요하다”, “YouTube가 핵심이다” 같은 단정이 나온다.
현재 확인한 연구로 그런 보편 우위를 입증할 수는 없다. 2026년 발리 4,776개 업장을 점검한 Vladimir Pitenin의 프리프린트에서는 자사 웹사이트 보유, 리뷰 규모, 가격 정보, 제3자 웹 언급이 후보 진입과 서로 다른 정도로 연관됐다.3 이 결과 역시 단일 지역·영어 질문·회사 지원 연구이므로 모든 업종과 플랫폼에 일반화할 수 없다.
즉 제3자 정보가 중요할 수 있다는 것과 모든 산업에서 특정 커뮤니티나 영상 플랫폼이 항상 최우선이라는 것은 전혀 다른 주장이다.
Earned Evidence의 가치는 다른 데 있다. 내가 스스로 “친절하다”고 쓰는 것과 실제 고객이 “질문만 했는데도 계약을 재촉하지 않고 자세히 설명해줬다”고 쓰는 것은 정보의 성격이 다르다.
사업자는 제3자의 평가를 통제할 수 없다. 대신 실제 경험을 관리하고, 거짓 리뷰가 아니라 진짜 피드백이 남을 수 있는 구조를 만들 수 있다.
5. Authority Evidence — 누가 확인해줄 수 있는가
다섯 번째는 권위 출처다.
- 정부기관
- 공공기관
- 학회
- 인증기관
- 자격정보
- 원 연구
- 공식 규정
특히 의료·법률·세무·금융처럼 잘못된 추천의 비용이 큰 분야에서 중요하다. 여기서도 “공공기관이면 무조건 우선 인용된다”는 공식을 만들 수는 없다.
하지만 CiteTrace 연구가 보여준 것처럼 citation이 존재하더라도 질문에 부적합한 도메인이 선택되는 문제가 실제로 관찰된다. 대규모 분석에서 27.1%의 citation pair가 domain-inappropriate로 분류됐다.4
이른바 YMYL(Your Money or Your Life) 분야에서는 단순히 “출처가 있느냐”가 아니라 그 질문을 뒷받침하기에 적절한 출처냐를 별도로 봐야 한다.
사업자에게도 같은 원칙이 적용된다. “우리는 세법을 잘 압니다”보다 국세청의 공식 규정과 서비스 설명이 모순되지 않는지가 더 중요하다.
6. Experience Evidence — 실제 경험이 남긴 구체성
마지막은 경험이다.
- 실제 고객 후기
- 사용기
- 상담 경험
- 장기 사용 경험
- 실제 방문 경험
- 실패와 제한을 포함한 구체적 사례
Experience Evidence를 Earned Evidence와 따로 두는 이유가 있다. 언론 기사도 earned다. 리뷰도 earned다.
반면 경험 증거는 실제로 사용해본 사람이 무엇을 겪었는가에 초점을 둔다. 호텔 페이지를 생각해보자. “조용한 객실”이라고 쓰여 있는 것과 최근 투숙객들이 실제 방음 상태를 반복적으로 언급하는 것은 다르다.
전자제품 공식 페이지에 “하루 종일 가는 배터리”라고 쓰여 있는 것과 특정 작업에서 실제 몇 시간을 썼다는 리뷰도 다르다.
공식 사양과 경험 증거는 서로 대체하지 않는다. 둘 다 필요할 수 있다.
Evidence Map은 ‘출처 수집표’가 아니다
여기서 차이를 하나 더 보자. Evidence Map을 이렇게 만들면 실패한다.
| 채널 | 보유 여부 |
|---|---|
| 홈페이지 | 있음 |
| 블로그 | 있음 |
| 유튜브 | 있음 |
| 리뷰 | 있음 |
| 인스타그램 | 있음 |
이것은 채널 목록이다. 어떤 질문에 답하는지 알 수 없다. Evidence Map은 질문에서 시작해야 한다.
예를 들어 가족여행 장소라면:
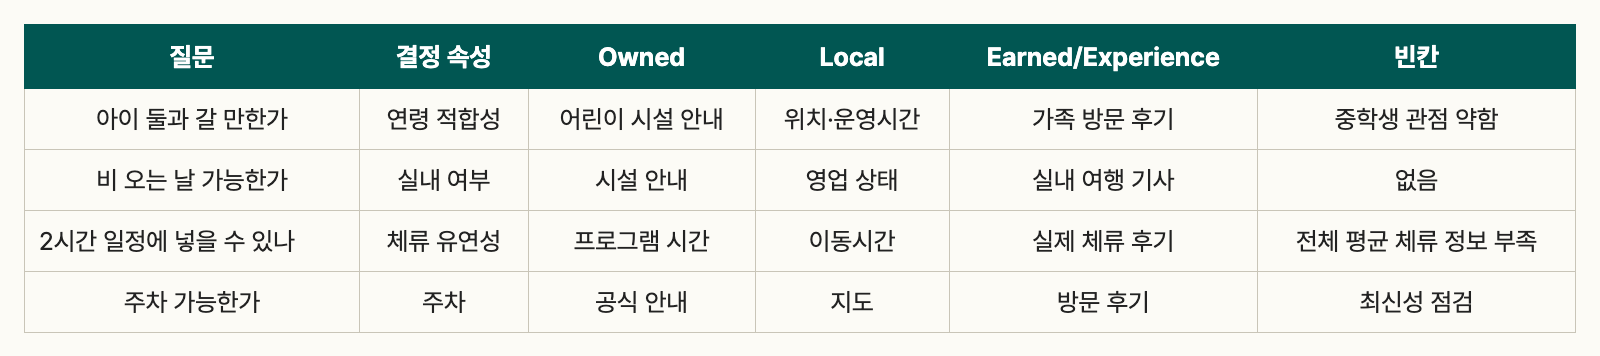
Evidence Map은 ‘출처 수집표’가 아니다 표 양식
이제 무엇을 만들지 보인다. 질문마다 새 페이지를 만들 필요가 없다. 비어 있는 사실을 채우면 된다.
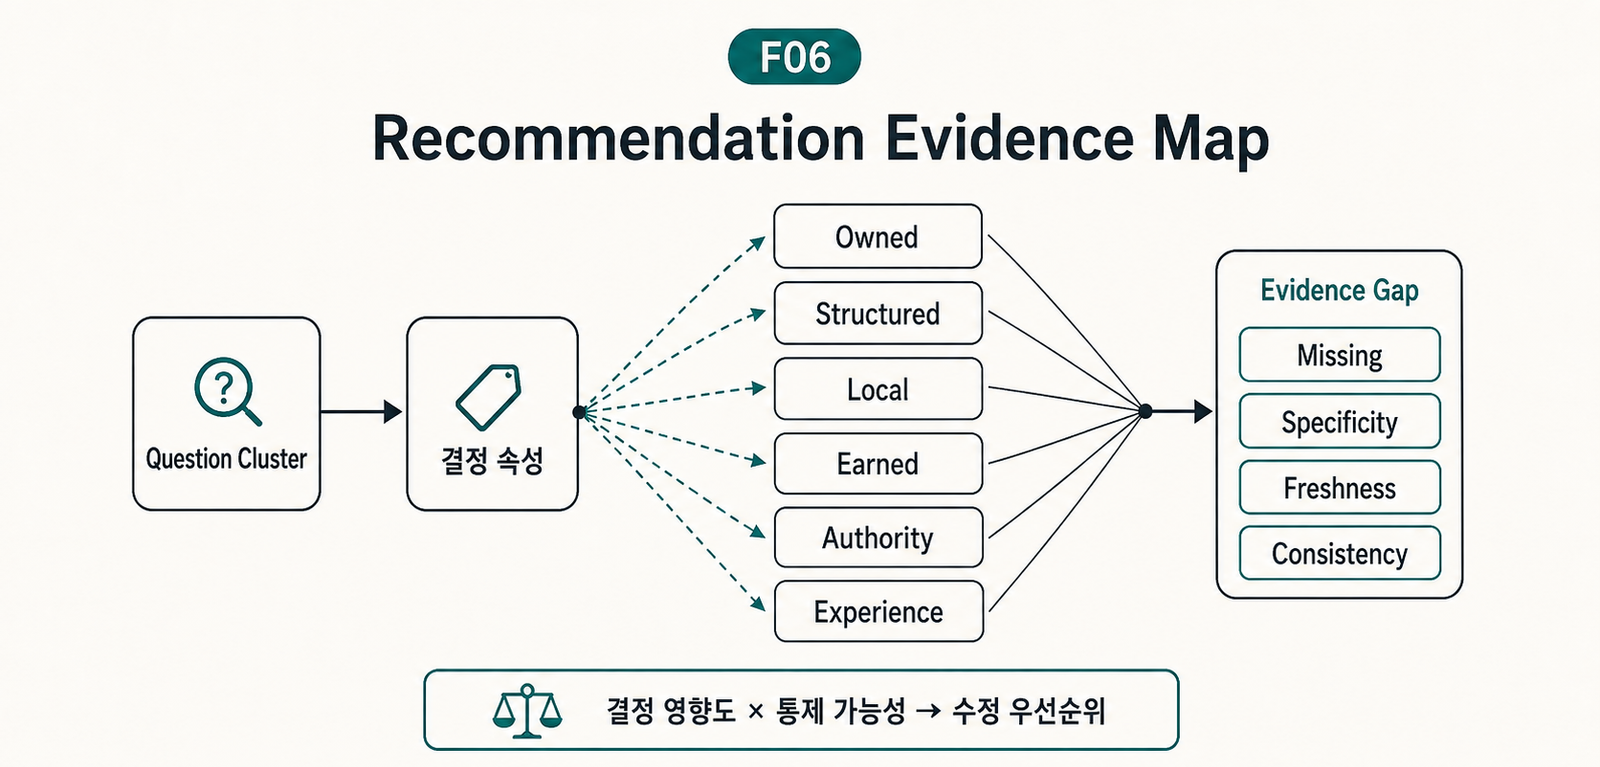
도판 F06. 질문에서 결정 속성을 뽑고 여섯 Evidence 층과 대조한 뒤 가장 중요한 빈칸을 수리한다.
문장을 다듬기 전에 사실을 수리하라
2026년 Diagnosing and Repairing Citation Failures 연구는 전체 문서를 무작정 다시 쓰기보다 문제가 되는 부분을 진단하고 제한된 텍스트를 수정하는 접근을 다뤘다. 연구에서는 문서의 일부만 겨냥해 수정하는 targeted repair를 핵심 전략으로 사용했다.5
또 다른 2026년 연구는 단순한 lexical 변화보다 정보적 특징을 먼저 고려하는 방향을 제안했다.6
이 연구들을 그대로 웹마케팅 매뉴얼로 옮길 수는 없다. 하지만 Evidence Map의 철학과는 잘 맞는다. 전체를 AI스럽게 다시 쓰지 말고, 필요한 정보가 비어 있는 지점을 찾아 고친다.
가격이 없다면 가격을 넣는다.
운영시간이 오래됐으면 갱신한다.
누구에게 맞는지 불분명하면 조건을 쓴다.
공식자료와 설명이 충돌하면 바로잡는다.
사용자가 자주 묻는 제한이 있는데 숨겨져 있다면 드러낸다.
이 편이 훨씬 지속가능하다.
Evidence의 A/B/C 등급
실무에서는 증거의 강도도 나누는 편이 좋다.
A — 공식적으로 직접 지원되는 데이터나 검증 가능한 사실
예:
- 상품 feed
- 가격
- 재고
- 공식 영업시간
- 정부 자격정보
B — 도움이 될 가능성이 높지만 추천 인과가 직접 입증되지는 않은 정보
예:
- Organization/SameAs 같은 entity consistency
- 비교적 일관된 제3자 언급
- 최근의 구체 리뷰
C — 업계에서 많이 말하지만 일반적 효과가 검증되지 않은 전술
예:
- 특정 formatting만 바꾸기
- 모든 페이지를 질문형으로 만들기
- AI용 문장을 무조건 길게 쓰기
- 새 파일 하나로 추천률이 오른다고 믿기
이 분류의 목적은 기술을 평가절하하는 것이 아니다. 증거 수준과 기대효과를 맞추기 위해서다.
실습 — Recommendation Evidence Map 한 장 만들기
자신의 사업에서 중요한 상황 질문 하나를 고른다. 예:
“아직 매출이 크지 않은 1인 출판사가 사업자등록 전에 한 번 상담받기 좋은 세무사를 추천해줘.”
그리고 아래 표를 채운다.
| 항목 | 내용 |
|---|---|
| 사용자 | 초기 1인 출판사 |
| 문제 | 사업자등록 전 세무 판단 |
| 핵심 제약 | 매출 작음, 당장 월 기장 부담 |
| 결정 속성 1 | 초기 상담 가능 여부 |
| 결정 속성 2 | 출판/콘텐츠 업종 이해 |
| 결정 속성 3 | 상담비용/기장 전환 조건 |
| 결정 속성 4 | 비대면 또는 지역 접근성 |
| Owned Evidence | |
| Structured/Local Evidence | |
| Earned Evidence | |
| Authority Evidence | |
| Experience Evidence | |
| 가장 큰 빈칸 | |
| 갱신해야 할 정보 |
여기에서 빈칸이 나온다. 그 빈칸이 GEO 콘텐츠 기획의 시작점이다.
AI에게 더 잘 보이려고 문장을 늘리기 전에, 고객과 AI가 확인할 사실의 빈칸부터 없애라.
증거가 충분해도 마지막에는 적합성이라는 문제가 남는다.
1. Vishwakarma et al., What Gets Cited (2026). 6 LLM, 252k trials, 2-doc injected experiment. relevance/position strongest, price/recency help, formatting effect weak. 공개 웹 end-to-end retrieval과 동일시하지 않음. https://arxiv.org/abs/2605.25517
2. Google Search Central AI optimization guide와 OpenAI product discovery 공식문서. Google은 generative AI Search를 위한 special schema를 요구하지 않지만 Merchant Center와 Business Profile 등 최신 구조화·비즈니스 정보를 공식 관리 지점으로 안내한다. OpenAI도 product discovery에서 merchant product data/feed를 사용한다. 플랫폼 공식 지원과 일반 LLM 추천 인과를 구분한다. https://developers.google.com/search/docs/fundamentals/ai-optimization-guide ; https://openai.com/index/powering-product-discovery-in-chatgpt/
3. Vladimir Pitenin, Invisible to the Machine (2026-08), 프리프린트. Bali 4,776 venues, 2,208 runs, 4 assistants, 96 persona queries. 85.6% never recommended; entry에서 own website OR 1.92, review volume 1.64, price 1.54, third-party web mentions 1.44. company-funded·단일 지역/언어라는 한계. https://arxiv.org/abs/2608.07069
4. Seo et al., Verified Misguidance / CiteTrace (2026), 프리프린트. YMYL에서 citation presence와 source suitability를 구분하는 근거로 제한해 사용한다. https://arxiv.org/abs/2605.28565
5. Tian et al., Diagnosing and Repairing Citation Failures (2026). GEO corpus에서 targeted repair를 다룸. https://arxiv.org/abs/2603.09296
6. Zikang Liu & Peilan Xu, Think Before Writing: FeatGEO. ACL 2026, peer-reviewed, pp. 20290–20303, DOI 10.18653/v1/2026.acl-long.929. informational feature를 선행하는 방향을 제안하며 LLM-judge·실험환경 한계는 남는다. https://aclanthology.org/2026.acl-long.929/