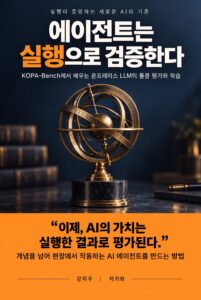
EPUB으로 소장하기
전체 내용과 부록을 EPUB으로 읽고 소장할 수 있습니다.
9,900원
API는 모두 정상 응답했다. 서버는 200 OK를 돌려줬고 JSON도 깨지지 않았다. 인증 오류도 없었다. 에이전트는 필요한 도구를 골랐고, 받은 데이터를 읽어 자연스러운 문장으로 정리했다. 시연 화면만 봤다면 꽤 잘 만든 시스템처럼 보였을 것이다. 그런데 답은 틀렸다.
원인은 아주 작았다. 목록 응답에 다음 페이지가 있다는 표시가 있었는데, 에이전트는 첫 페이지만 읽고 일을 끝냈다. 첫 페이지 안에서 한 요약은 틀리지 않았다. 문제는 사용자가 요구한 일이 첫 페이지를 요약해 달라가 아니었다는 데 있었다. 호출은 성공했고, 업무는 실패했다. 이 차이가 이 책의 출발점이다.
지난 몇 년 동안 우리는 LLM이 도구를 쓰게 만드는 데 많은 힘을 쏟았다. function calling, tool use, MCP 같은 말은 이제 낯설지 않다. 그래서 자연스럽게 다음 기대가 생긴다. 도구를 제대로 호출할 수 있다면 이제 일을 맡길 수 있지 않을까. 바로 여기서 착시가 시작된다. 사람에게는 한 문장인 업무가 에이전트에게는 여러 번의 호출로 쪼개지고, 그 호출들 사이에 의존성이 생긴다. 선행 조회를 건너뛰면 뒤의 모든 호출이 잘못된 전제 위에 선다. 페이지를 끝까지 읽지 않으면 부분 결과가 완성본처럼 나간다. 상태를 바꾸는 업무라면 실행 전과 후를 비교해야 한다. 이런 실패는 오류 메시지의 모양을 하고 오지 않는다. 아무것도 빨갛게 뜨지 않은 채 조용히 틀린다.
이 책은 그 조용한 실패를 해부하고 측정 가능한 것으로 바꾼다. 한국 공공 API로 만든 다단계 툴콜 벤치마크 KOPA-Bench와, 실행으로 검증한 데이터 합성 방식 EDGE를 주요 출발점으로 삼는다. 다만 특정 논문의 해설서는 아니다. API-Bank, BFCL, tau-bench, ToolSandbox, ToolHop, APIGen, ToolACE 같은 선행 연구와 나란히 놓고 무엇이 이미 있었고 무엇이 새로 더해졌는지 구분한다. 목표는 공개 벤치마크를 구경하는 데서 멈추지 않고 그 아이디어를 조직의 평가 체계로 옮기는 것이다.
책은 네 부로 이어진다. 1부는 실패를 발견한다. 200 OK가 업무 완료 증명서가 아닌 이유, 한 문장 요청이 어떻게 실행 그래프로 바뀌는지, 모델을 교체하기 전에 툴 계약부터 봐야 하는 이유를 다룬다. 2부는 성공을 측정한다. 응답과 실행과 환경 상태를 분리하고, 한 번의 성공과 반복되는 성공을 구분하며, 실패를 설명할 수 있는 로그가 무엇인지 정한다. 벤치마크 자체가 틀릴 수 있다는 사실도 정면으로 다룬다. 3부는 실패를 데이터로 바꾼다. 그럴듯하게 합성된 궤적을 실제 실행으로 걸러내고, 어떤 데이터가 SFT와 GRPO 같은 학습으로 이어질 수 있는지 판단한다. 4부는 운영이다. 비용과 지연, 읽을 권한과 바꿀 권한, 사람 승인과 인계, 무엇이 바뀌면 무엇을 다시 시험할지까지 연결한다.
책 전체에 EXEC-MINI라는 작은 실행 검증 미니벤치가 반복해서 등장한다. 6개 도구, 12개 과제, 5종 오류 주입으로 이루어진 고정 실습 환경이다. 초반에는 일부러 실패하고, 중반에는 그 실패를 여러 층으로 나눠 측정하며, 후반에는 실행 로그에서 학습 데이터 후보를 만들고, 마지막에는 같은 업무를 다시 시험한다. 부록에는 과제 팩, 툴 계약서 양식, 최소 트레이스 스키마, 실패 분류 빠른 참조, 회귀 매트릭스와 릴리스 게이트를 바로 쓸 수 있는 양식으로 실었다.
이 책은 특정 모델을 추천하지 않는다. 더 큰 모델이 언제나 답이라고 말하지도 않는다. 대신 무엇을 성공이라고 부를지 먼저 적고, 실패에 주소를 붙이고, 고친 뒤 같은 시험을 다시 통과하는지 확인하는 순서를 제안한다. 사내 에이전트를 만들거나 평가해야 하는 개발자와 기획자, 온프레미스 LLM 도입을 검토하는 공공기관과 기업의 실무자, 툴콜 학습 데이터를 직접 만들어야 하는 팀에게 특히 쓸모가 있다.
완벽한 에이전트를 약속하지는 않는다. 다만 실패했을 때 어디에서 왜 실패했는지 말할 수 있고, 수정한 뒤 같은 시험을 다시 통과할 수 있는 시스템을 만드는 방법은 끝까지 밝힌다.
서지정보
| ISBN | 9791143825322 |
|---|---|
| 발행처 | 작가와 |
| 웹 공개 | 보이드로그 |
| 출간일 | 2026-09-16 |
| 형식 | EPUB3 |
| 언어 | 한국어 |
| 이용등급 | 제한없음 |
| 정가 | 9,900원 |
전체 목차
- 여는 글. 성공한 호출이 실패한 업무가 되는 순간
- PART 1. 실패를 발견한다
- 1장. 모든 API가 성공했는데 왜 답은 틀렸을까
- 2장. 함수 호출의 착시, 한 번 부르는 것과 일을 끝내는 것
- 3장. 사용자에게 한 문장, 에이전트에게는 실행 그래프
- 4장. 모델을 바꾸기 전에 툴 계약부터 보라
- PART 2. 성공을 측정한다
- 5장. 세계의 벤치마크는 무엇을 더 보기 시작했나
- 6장. KOPA-Bench 145과제는 무엇을 시험했나
- 7장. ACTION이 맞아도 업무는 실패할 수 있다
- 8장. 한 번의 성공보다 반복되는 성공이 어렵다
- 9장. 실패를 설명할 수 있는 로그를 남겨라
- 10장. 벤치마크도 틀릴 수 있다
- PART 3. 실패를 데이터로 바꾼다
- 11장. 그럴듯한 합성 데이터가 가장 위험할 때
- 12장. APIGen과 ToolACE가 먼저 풀어 놓은 문제
- 13장. EDGE, 될 것 같은 연결을 실제 API가 반박하게 하라
- 14장. 그래프에서 실행 가능한 궤적을 만든다
- 15장. 더 큰 모델인가, 더 좋은 실행 데이터인가
- PART 4. 운영한다
- 16장. 온프레미스 모델을 고르는 질문부터 바꿔라
- 17장. 읽을 권한과 바꿀 권한은 같은 툴콜이 아니다
- 18장. 우리 조직의 벤치마크를 만들고 매번 다시 돌려라
- 닫는 글. 좋은 에이전트는 실패를 설명할 수 있는 시스템이다
- 부록 A. EXEC-MINI Task Pack
- 부록 B. Tool Contract Sheet
- 부록 C. Minimum Agent Trace Schema
- 부록 D. Failure Taxonomy Quick Reference
- 부록 E. Regression Matrix and Release Gate
- 부록 F. Source and Attribution Notes
- 참고문헌 및 공식 자료
저자 소개
강지우는 복잡한 분야를 확인할 수 있는 순서로 바꾸는 실용서를 쓰는 필명이다. 연금과 투자, 업무 도구, 농업과 식품처럼 서로 먼 주제를 오가지만 방법은 하나다. 지식의 양보다 무엇을 먼저 확인하느냐가 결과를 가른다고 보고, 흩어진 정보를 손에 쥘 수 있는 절차로 바꾸는 일을 이어 왔다. 개념을 길게 설명하기보다 판단이 갈리는 지점을 앞에 두고, 독자가 직접 대조할 수 있는 표와 순서를 남기는 쪽을 택한다. 결과를 약속하지 않는 대신 무엇을 먼저 확인하면 되는지는 끝까지 밝힌다. 특정 분야의 전문가 자격으로 쓰지 않으며, 금융·건강처럼 판단에 쓰이는 주제는 원 자료의 조건과 범위를 함께 적는다.
같은 저자의 다른 책
최종 수정일 2026년 9월 28일
이 콘텐츠는 저자가 기획하고 AI 도구를 집필·정리 과정에 활용했습니다. 구성, 사실 확인, 표현, 최종 판단과 출판 책임은 저자와 보이드로그에 있습니다.