SKU가 같으면 시스템에서도 같은 물건일까요.
회의에서 이 질문을 던지면 대개 잠깐 정적이 생깁니다. 상품 코드가 같으니 같은 물건이라고 답하기에는 어딘가 불안합니다. 창고에는 같은 상품 코드가 붙은 박스가 수십 개 있고, 그중 일부는 유통기한이 다르고, 어떤 것은 이미 특정 주문에 배정됐으며, 어떤 것은 검수 보류 상태일 수 있기 때문입니다. 자동화 창고라면 같은 상품이 서로 다른 토트와 팔레트에 나뉘어 있고 각각 다른 위치를 지나고 있을 수도 있습니다.
화면에는 한 줄로 보이는 품목이 현장에 내려오면 여러 축으로 갈라집니다. 이 구분을 건너뛰면 뒤에서 나오는 로케이션, 재고 상태, 할당, 피킹, 설비 연동이 전부 흐려집니다. 개발자에게는 특히 치명적입니다. API의 skuCode 하나를 보고 그 값이 실물 한 개를 가리킨다고 착각하면 데이터 모델부터 잘못 읽게 됩니다.
이 장에서 붙잡을 문장은 하나입니다.
같은 SKU라는 사실은 같은 실물 객체라는 뜻이 아닙니다.
상품을 가리키는 것과 수량을 세는 것은 다른 일입니다
SKU는 Stock Keeping Unit의 약자입니다. 이 책에서는 재고 관리와 주문 처리에서 구분해야 하는 상품 식별 단위라는 뜻으로 사용합니다. 어떤 티셔츠가 색상과 사이즈에 따라 별도 SKU로 나뉠 수도 있고, 같은 상품명이더라도 판매·재고 정책에 따라 관리 단위가 달라질 수 있습니다. 상품 분류 정책 자체보다 SKU가 답하는 질문이 무엇인지 보겠습니다.
SKU가 답하는 질문은 대체로 이쪽에 가깝습니다.
“무슨 상품입니까.”
반대로 SKU만으로는 다음 질문에 답할 수 없습니다.
“몇 개입니까.”
“어느 생산 묶음입니까.”
“어느 박스 안에 있습니까.”
“창고 어디에 있습니까.”
“어느 주문에 배정됐습니까.”
“지금 누가 무엇을 해야 합니까.”
이 질문마다 다른 데이터 축이 필요합니다.
예를 들어 SKU FD-A100이라는 포장 간식이 있다고 하겠습니다. 창고에 이 SKU가 240개 있습니다. 여기까지는 간단합니다. 그런데 공급업체는 12개씩 한 Case로 납품하고, 창고는 입고 때 Case 단위로 스캔하며, 온라인 주문은 Each 단위로 들어온다고 해보겠습니다. 같은 240이라는 재고도 화면에 따라 240 Each, 20 Case로 보일 수 있습니다.
이때 등장하는 것이 UOM(Unit of Measure), 즉 수량을 표현하는 단위입니다. Each, Pack, Box, Case, Pallet 같은 값이 여기에 들어갈 수 있습니다. 실제 창고 시스템에서는 구매 단위, 판매 단위, 재고 단위가 서로 다를 수 있고 단위 간 변환 관계를 관리하기도 합니다.
1 Case = 12 Each라는 관계는 수량을 변환하는 규칙입니다. 이 문장을 읽고 실제 창고에 Case라는 물체가 하나 존재한다고 곧바로 결론 내리면 안 됩니다. UOM은 수량 표현의 축이고, 포장 계층은 실물이 어떻게 묶여 있는지를 설명하는 축입니다. 현실에서는 둘이 자주 겹쳐 보여서 더 헷갈립니다.
창고 바닥에 팔레트 하나가 놓여 있다고 해보겠습니다. 그 위에 Case가 40개 있고 각 Case에는 Each가 12개씩 들어 있습니다. 수량만 보면 480 Each, 40 Case, 1 Pallet처럼 환산할 수 있습니다. 하지만 작업자가 Case 하나를 뜯어 Each 세 개를 꺼낸 순간 물리 포장 구조와 단순 수량 환산은 서로 다른 문제가 됩니다. 남은 Case가 완전한 Case인지, 개봉 Case인지, 낱개가 어느 용기에 담겼는지까지 관리하려면 UOM만으로는 부족합니다.
그래서 데이터 모델을 볼 때는 “이 값이 수량 단위인가, 실제 취급 객체인가”를 따로 물어야 합니다.
포장 계층은 실물이 묶이는 방식입니다
상품이 Each에서 Inner, Case, Pallet으로 묶이는 구조를 포장 계층이라고 부르겠습니다. 상품마다 포장 단계는 다릅니다. 어떤 상품은 낱개와 Case만 있을 수 있고, 어떤 상품은 부피가 커서 Each 자체가 팔레트에 고정될 수도 있습니다. 사업장마다 사용하는 이름도 다릅니다.
포장 계층이 중요한 이유는 창고 작업이 상품 하나하나만을 대상으로 일어나지 않기 때문입니다. 입고는 Pallet 단위로 받고, 보충은 Case 단위로 이동하며, 피킹은 Each 단위로 수행하는 식으로 작업 단위가 달라질 수 있습니다.
여기서 개발자가 확인할 것은 포장 이름의 표준 여부보다 변환이 일어나는 지점입니다.
입고에서는 Pallet 하나로 들어왔는데 적치 뒤에 Case 단위로 쪼개집니까.
보충 작업에서 Case를 피킹 존으로 이동한 뒤 Each 단위로 판매합니까.
포장 작업에서 여러 Each를 새 Carton에 다시 묶습니까.
이 질문을 따라가면 단순한 품목 마스터를 넘어 실제 물류 객체가 보이기 시작합니다.
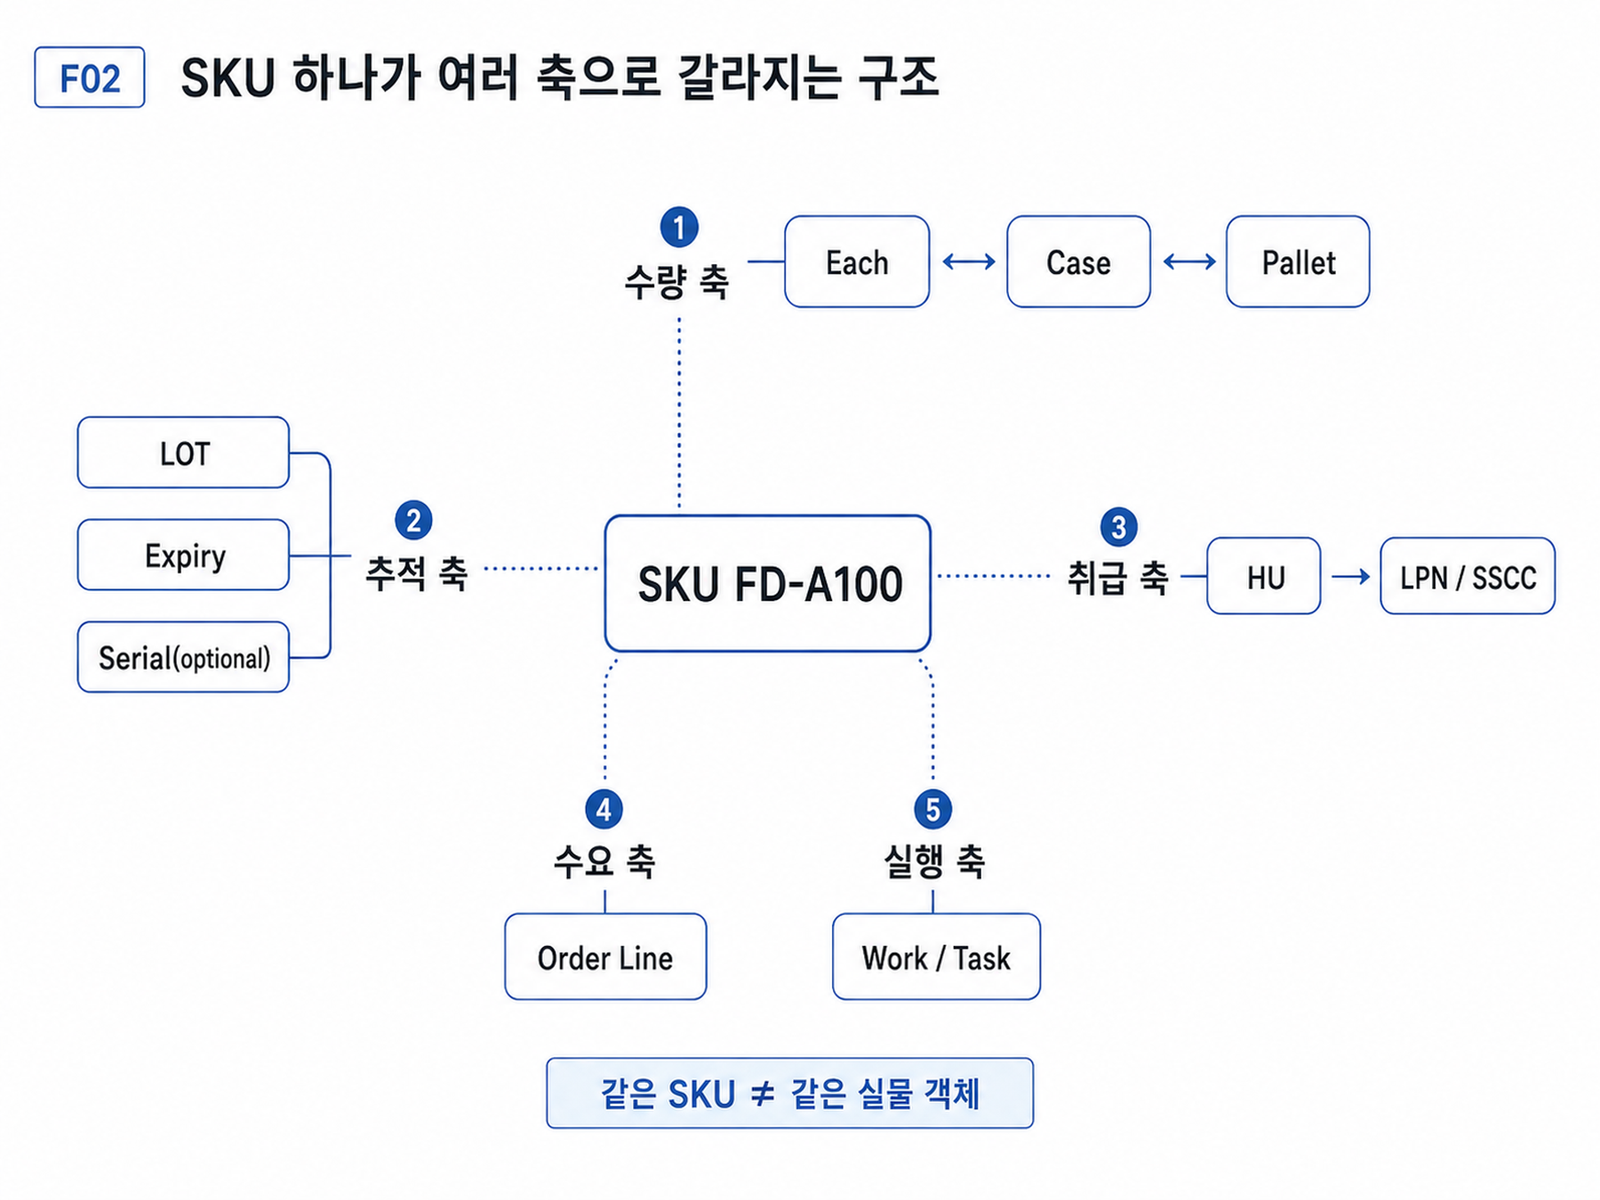
도판 F02
도판에서는 Each–Case–Pallet과 LOT–Serial–HU를 한 줄 계층으로 그리지 않습니다. 각각이 답하는 질문이 다릅니다. 수량 관계와 추적 관계와 취급 관계를 섞는 순간 그림은 간단해지지만 시스템은 설명하지 못합니다.
같은 SKU를 다시 갈라놓는 LOT와 유통기한
SKU FD-A100이 두 팔레트 들어왔다고 하겠습니다. 상품 코드는 같습니다. 하나는 이번 주 생산분이고 다른 하나는 지난달 생산분입니다. 둘의 LOT가 다르면 창고는 같은 SKU를 다시 나눠 관리할 수 있습니다.
LOT는 생산·입고·품질·추적 등의 목적으로 같은 묶음으로 관리하는 속성입니다. 현장에서는 Batch라는 말을 같은 의미로 쓰는 경우도 많습니다. 이 책에서는 기본 표기를 LOT로 통일하겠습니다.
LOT가 필요한 이유는 “무슨 상품인가”만으로는 추적이 끝나지 않기 때문입니다. 특정 생산 묶음에 품질 문제가 발견됐다고 해보겠습니다. SKU만 알고 있다면 창고 안의 해당 상품 전체를 대상으로 확인해야 합니다. LOT가 기록돼 있으면 문제의 범위를 좁힐 수 있습니다.
유통기한이나 소비기한처럼 날짜 속성이 붙는 상품도 비슷합니다. 이 책에서는 표시 제도나 법규를 다루지 않습니다. 시스템 관점에서 볼 것은 날짜가 재고 선택 규칙에 참여할 수 있다는 점입니다. 같은 SKU가 같은 로케이션에 있어도 어떤 LOT를 선행 피킹할지, 특정 날짜가 지난 재고를 판매 가능한 상태로 둘지 같은 판단이 생깁니다.
LOT는 SKU를 대체하지 않습니다. 한 SKU 아래 여러 LOT가 존재할 수 있습니다. 반대로 LOT 번호가 같다고 전사적으로 같은 의미라고 단정하기도 어렵습니다. LOT 키가 품목과 함께 유일해지는 구현도 있고, 공급망 전체에서 다른 식별 규칙을 적용하는 경우도 있습니다. 시스템 설계에서는 값 하나보다 유일성의 범위를 확인해야 합니다.
“LOT 번호가 같으면 같은 재고인가요.”라는 질문에는 그래서 바로 예나 아니오로 답하기 어렵습니다. 어떤 품목에 붙은 LOT인지, 어느 소유자·사업장·재고 차원을 함께 보는지 확인해야 합니다.
Serial은 묶음보다 더 작은 질문을 합니다
어떤 상품은 LOT 수준으로도 부족합니다. 동일 모델의 장비 100대가 들어왔는데 각각의 개체를 보증·수리·추적해야 한다면 개별 식별이 필요합니다. Serial이 등장하는 자리입니다.
LOT가 묶음을 추적한다면 Serial은 개별 개체를 추적합니다. SKU가 같고 LOT도 같아도 Serial이 다르면 시스템에서는 서로 다른 개체로 추적할 수 있습니다.
여기서도 과잉 일반화는 피해야 합니다. Serial 관리 대상은 일부 품목에 한정됩니다. 빠르게 소비되는 저가 상품까지 개별 Serial로 추적하면 운영 부담이 커집니다. 반대로 고가 전자기기, 장비, 특정 규제 품목처럼 개별 추적 가치가 큰 상품은 Serial이 중요한 축이 됩니다.
API 설계에서는 이 차이가 더 노골적으로 드러납니다. 어떤 입고 인터페이스는 sku, qty, lot만 받습니다. 다른 인터페이스는 수량 10개를 보내면서 serial 목록 10개를 함께 요구할 수 있습니다. 두 메시지는 모두 “10개 입고”를 표현하지만 데이터 구조가 다릅니다.
개발자에게 필요한 습관은 필드 수보다 식별의 해상도를 보는 것입니다. SKU 수준인지, LOT 수준인지, 개체 수준인지부터 가릅니다.
창고는 상품만 옮기지 않습니다
이제 팔레트 하나를 생각해보겠습니다. 팔레트 위에 서로 다른 SKU 세 종류가 섞여 있고 각각 여러 Case가 실려 있습니다. 지게차 작업자는 이 팔레트를 통째로 다른 구역으로 옮깁니다. 시스템이 각 Each를 하나씩 이동 처리할 필요는 없습니다. 이때 유용한 개념이 물류 취급 단위(Handling Unit, HU)입니다.
HU는 운송·보관·창고 작업에서 하나의 단위로 취급할 수 있도록 상품과 포장재를 묶은 물류 단위입니다. 팔레트가 대표적이지만 카톤, 토트, 케이지 같은 형태도 HU 관점으로 다뤄질 수 있습니다. 어떤 구현에서는 HU 안에 다른 HU가 들어가는 중첩 구조도 가능합니다.
HU가 답하는 질문은 “무슨 상품인가”보다 “지금 무엇을 한 덩어리로 취급하고 있는가”에 가깝습니다.
팔레트 HU 하나에 SKU A 20 Case와 SKU B 10 Case가 들어 있을 수 있습니다. 반대로 SKU A 20 Case가 두 개의 팔레트 HU에 나뉠 수도 있습니다. 그래서 SKU와 HU의 관계는 1대1이 아닙니다.
여기에 LPN(License Plate Number)이 붙습니다. LPN은 창고에서 물류 취급 단위를 가리키기 위해 붙이는 식별 번호나 라벨 개념으로 사용하겠습니다. 작업자는 팔레트 안의 상품 바코드를 하나씩 다시 읽지 않고 LPN 하나를 스캔해 해당 취급 단위를 선택할 수 있습니다.
HU와 LPN은 비슷하게 들리지만 질문이 다릅니다. HU는 취급되는 단위에 초점을 둡니다. LPN은 그 단위를 가리키는 식별자에 초점을 둡니다. 특정 시스템에서는 둘이 거의 1대1처럼 보일 수 있지만 책 전체에서 둘을 같은 개념으로 합치지 않습니다.
국제 물류에서는 물류 단위를 식별하는 표준 키로 SSCC(Serial Shipping Container Code)를 쓰는 체계도 있습니다. 여기서 얻을 교훈은 특정 표준 번호를 외우라는 것이 아닙니다. 상품을 식별하는 코드와 운송·보관 중인 물류 단위를 식별하는 코드는 서로 다른 문제를 푼다는 점입니다.
한 가지 물건을 시스템에서 찾을 때 다음과 같은 값이 동시에 붙을 수 있습니다.
- SKU는 상품 종류를 가리킵니다.
- UOM은 수량 표현 단위를 알려줍니다.
- LOT는 생산·추적 묶음을 구분합니다.
- Serial은 필요할 때 개별 개체를 구분합니다.
- HU는 함께 취급하는 물류 단위를 나타냅니다.
- LPN은 그 취급 단위를 스캔하고 참조할 식별자가 됩니다.
이 목록을 외울 필요는 없습니다. 어떤 값이 무엇을 식별하는지만 놓치지 않으면 됩니다.
식별자는 생명주기도 다릅니다
같은 화면에 노출되는 코드라도 언제 만들어지고 언제 사라지는지는 다릅니다. SKU는 상품을 관리하는 동안 오래 유지될 수 있습니다. LOT는 특정 생산·입고 묶음의 추적 기간 동안 의미를 갖습니다. LPN은 포장 변경이나 HU 분해·병합 과정에서 새로 발급되거나 관계가 바뀔 수 있습니다. Work ID는 작업이 생성되고 완료되는 짧은 생명주기를 가집니다. Order ID는 고객 주문의 이행이 끝날 때까지 이어집니다.
이 차이를 무시하면 외래키 하나로 여러 객체를 억지로 묶게 됩니다. 예를 들어 LPN을 영구 재고 ID처럼 사용하면 재포장 순간에 식별 관계가 끊길 수 있습니다. Order ID를 물리 작업 ID로 쓰면 한 주문이 여러 작업으로 갈라지는 순간 추적이 어려워집니다. 데이터 모델에서는 값의 모양보다 객체가 태어나고 바뀌고 종료되는 조건을 함께 확인해야 합니다.
재고는 이 축들이 만나는 지점에서 생깁니다
“재고 100개”라는 말은 시스템 설계에서는 정보가 너무 적습니다. 어떤 SKU인지, 어느 사업장과 창고인지, 어느 로케이션인지, 어떤 상태인지, 어떤 LOT인지, 어느 HU에 담겨 있는지에 따라 같은 100개가 여러 행으로 갈릴 수 있습니다.
가상의 예를 하나 보겠습니다.
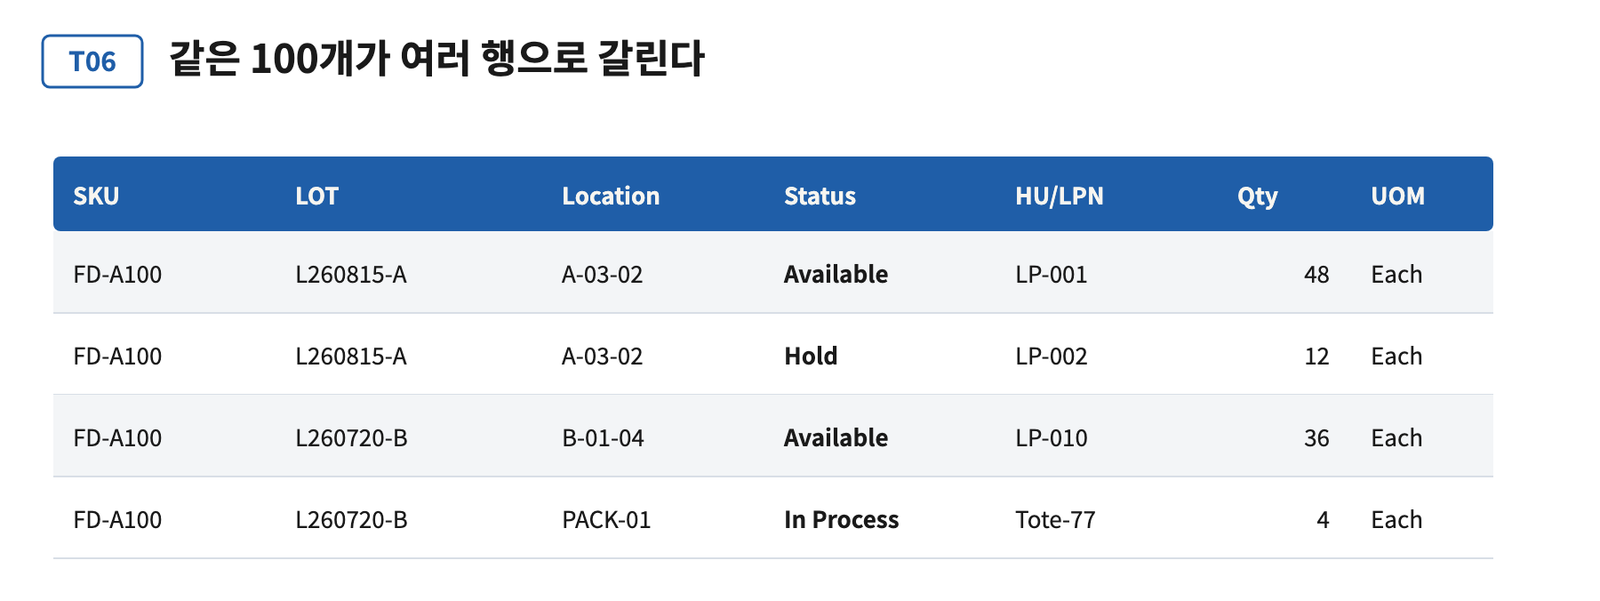
표 T06 — 같은 100개가 여러 행으로 갈린다
합계는 100 Each입니다. 그렇다고 네 행을 무조건 합쳐 하나의 “재고 100”으로 처리할 수는 없습니다. 위치가 다르고 상태가 다르며 LOT가 다르고 취급 단위도 다릅니다. 판매 가능 수량을 묻는 화면이라면 Hold와 In Process를 제외할 수 있습니다. 특정 LOT 회수 대상 수량을 묻는다면 L260815-A만 합산할 수 있습니다. 피킹 작업을 만들 때는 위치와 HU가 더 중요해집니다.
재고는 숫자 하나로 존재하는 것처럼 보이지만 시스템 안에서는 여러 차원이 만난 결과로 나타납니다. 어떤 차원을 실제로 관리하는지는 창고와 제품 구조에 따라 달라집니다. 다만 차원을 분리해서 생각하는 습관은 어느 시스템에서도 유효합니다.
이 지점에서는 품목·로케이션 같은 마스터 데이터와 계속 변하는 재고 상태 데이터를 구분해야 합니다. 품목이나 로케이션은 비교적 안정적인 기준정보로 볼 수 있습니다. 현재고, 가용 여부, 할당 상태, 작업 진행은 계속 변합니다. 전부 같은 마스터 영역에 넣어 생각하면 변경 책임과 동기화 방식을 잘못 잡게 됩니다.
주문은 상품을 요구하고 작업은 실물을 움직입니다
한 단계 더 내려가보겠습니다. 고객이 FD-A100 두 Case를 주문했습니다. 주문 시스템에는 Order와 Order Line이 생깁니다. 주문 한 줄에는 SKU와 수량이 들어가지만 아직 창고의 어느 Case를 집을지는 정해지지 않았을 수 있습니다.
창고관리시스템(WMS)이 주문 이행 요청을 받으면 재고를 배정하고 작업을 만들 수 있습니다. 이때 Allocation은 수요에 재고를 논리적으로 배정하는 판단입니다. 물리적으로 상품을 집었다는 뜻은 아닙니다.
피킹 작업이 만들어지면 작업자는 특정 로케이션으로 가서 특정 수량을 집습니다. 자동화 창고라면 장비가 HU를 이동시키거나 작업자 스테이션으로 가져올 수도 있습니다. 이제 Work나 Task 같은 실행 단위가 등장합니다.
여기서 객체가 한 번 더 갈라집니다.
주문은 고객이 무엇을 요구했는지를 말합니다.
Allocation은 어떤 공급을 그 요구에 배정했는지를 말합니다.
Work/Task는 실제로 무엇을 수행해야 하는지를 말합니다.
HU는 무엇을 한 덩어리로 취급해 움직이는지를 말합니다.
SKU는 그 안에 어떤 상품이 있는지를 말합니다.
이 다섯 가지를 한 객체로 설계하면 처음에는 단순해 보입니다. 주문 하나를 취소하거나, 일부 수량만 피킹하거나, 한 주문을 여러 창고에서 나눠 보내거나, 하나의 HU에 여러 주문 물량이 섞이는 순간 구조가 버티지 못합니다.
실무 회의에서 “주문 번호를 작업 키로 쓰면 되지 않나요”라는 말이 나오면 바로 반대할 필요는 없습니다. 대신 관계를 확인하면 됩니다. 한 주문에서 작업이 몇 개까지 나올 수 있는지, 하나의 작업이 여러 주문을 포함할 수 있는지, 취소와 재작업 때 키의 생명주기가 어떻게 되는지를 물어보면 됩니다. 객체 경계가 자연스럽게 드러납니다.
인터페이스 한 건에서도 축을 분리합니다
입고 API 한 건을 예로 들어보겠습니다. 요청에 sku, qty, uom, lot, lpn, location이 함께 들어온다면 필드가 많다는 인상부터 받을 수 있습니다. 이 값들은 같은 사실을 반복해서 적은 것이 아닙니다. 서로 다른 질문을 한 메시지 안에 묶은 것입니다.
sku는 상품을 가리킵니다. qty와 uom은 수량을 표현합니다. lot는 추적 묶음을 좁힙니다. lpn은 취급 단위를 찾는 데 쓰입니다. location은 어디에 놓이는지를 말합니다. 하나라도 의미가 빠지면 수신 시스템은 나머지 값으로 추정해야 하고, 그 추정이 사업 규칙과 어긋나면 재고가 잘못 갈립니다.
그래서 인터페이스 리뷰에서는 필드 이름보다 관계를 묻는 편이 좋습니다. qty=1, uom=Case가 들어왔을 때 재고 기준 UOM으로 언제 변환하는지, 같은 LPN 안에 여러 SKU나 LOT를 허용하는지, Location은 입고 도크인지 최종 적치 위치인지 확인합니다. 데이터 타입보다 객체 경계가 선행해서 정리돼야 하는 이유입니다.
다섯 종류의 질문을 분리하면 데이터 모델이 보입니다
지금까지 나온 말을 한 문장으로 압축하면 이렇습니다.
SKU, 재고, 물류 취급 단위, 주문 단위, 작업 단위는 서로 다른 질문에 답하는 객체입니다.
SKU ≠ 재고 ≠ 물류 취급 단위 ≠ 주문 단위 ≠ 작업 단위라는 표기는 수학식이 아닙니다. 설계 회의에서 같은 명사를 함부로 대체하지 말라는 경고에 가깝습니다.
SKU를 보면 “무슨 상품인가”를 묻습니다.
재고를 보면 “어떤 조건의 수량이 어디에 얼마나 있는가”를 묻습니다.
HU를 보면 “지금 무엇을 한 단위로 취급하는가”를 묻습니다.
Order를 보면 “무엇을 얼마나 이행해야 하는가”를 묻습니다.
Work/Task를 보면 “누가 또는 무엇이 지금 어떤 행동을 해야 하는가”를 묻습니다.
이 질문들이 연결되면서 물류 시스템이 만들어집니다. 하나의 FD-A100이라는 SKU에서 시작했는데 어느 순간 LOT, UOM, HU, LPN, Order Line, Allocation, Work가 주변에 붙었습니다. 화면만 보면 필드가 많아진 것처럼 보입니다. 현장을 기준으로 보면 서로 다른 현실을 각각 기록한 것입니다.
데이터 모델을 처음 받을 때 컬럼명을 외우는 대신 다섯 질문으로 분류해보십시오. 상품을 식별하는 값인지, 수량과 추적을 표현하는 값인지, 함께 옮길 단위를 가리키는 값인지, 수요를 표현하는 값인지, 실행할 일을 표현하는 값인지부터 나눕니다. 그다음 관계의 1대1, 1대다, 다대다를 확인하면 됩니다.
여기까지 구분하고 나면 새로운 문제가 생깁니다. 객체가 여러 개라는 사실은 알겠습니다. 그렇다면 그 객체들은 창고의 어디에 놓였다고 기록될까요. FD-A100 48 Each가 어느 로케이션에 있다고 말할 때, 그 “자리” 자체도 시스템 안에서는 규칙을 가진 데이터입니다.
다음 장에서는 로케이션이라는 데이터가 무엇을 담는지 이어서 보겠습니다.