가장 높은 점수 하나만 고르면 흐름이 끊긴다
화요일 오후 3시 10분, 한유진의 WS01에서 후보 점수 계산이 끝났다.
- 파일명·납품 목록 정리 73.7점
- 텍스트·수치 QA 71.9점
- 채널별 디자인 변환 67.8점
- 캠페인 요청 정리 63.5점
모두 [예시] 점수다. XLSX 워크시트의 수식으로 계산한 값이며 소수 첫째 자리에서 반올림했다.
가장 높은 파일 정리만 떼어내면 어느 파일이 승인본인지 판단하는 앞 단계는 그대로 남는다. QA만 고르면 구형 상품표나 잘못된 복제 파일이 들어오는 문제를 막지 못한다. 반대로 ‘Desk Reset Week 전체 자동화’라고 쓰면 브랜드 방향, 이미지 선택, 예외 레이아웃, 최종 시각 검수까지 범위에 들어간다.
유진은 점수 순위 대신 프로젝트의 시작과 종료를 그었다.
캠페인 요청과 상품 원본이 도착한 상태에서 시작해, 채널별 결과의 사람 검수와 QA·납품 기록에서 끝낸다.
자동 연결 구간은 캠페인 정보가 구조화되고 담당자가 approved 상태로 승인한 뒤에 시작한다. 생성 방향 선택과 최종 시각 판단은 사람의 승인 지점으로 남긴다.
점수는 비교 기준을 드러내는 수식이다
후보 점수는 결정을 대신하지 않는다. 여러 업무를 같은 항목으로 비교하기 위한 책의 도구다.
WS01 v1.0의 기본 배점은 다음과 같다.
| 항목 | 배점 | 계산 기준 |
|---|---|---|
| 월 반복 횟수 | 20 | 월 8회에서 상한 |
| 건당 소요 시간 | 20 | 240분에서 상한 |
| 입력 일정함 | 15 | 1~5점 |
| 완료 기준 명확성 | 15 | 1~5점 |
| 사람 최종 확인 가능 | 15 | 가능하면 15점 |
| 예외 부담 | 15 | 예외 0개는 15점, 5개 이상은 0점 |
상한과 배점은 산업 표준이 아니다. 이 책의 후보를 비교하기 위한 기본값이다. 조직의 업무 주기와 위험 수준이 다르면 점수보다 판정 근거를 우선한다.
automation_exclusion에 사유가 있으면 수식 결과와 관계없이 0점으로 처리한다. 페블폼의 메인 시안 방향 결정은 월 6회, 155분이지만 0점이다. 브랜드 방향의 최종 결정은 사람에게 남기기로 했기 때문이다.
73.7점이 63.5점보다 객관적으로 10.2만큼 더 자동화에 적합하다는 뜻도 아니다. 점수 뒤에 입력·출력, 예외, 제외 사유를 함께 본다.
같은 흐름을 공유하는 후보를 묶는다
텍스트·수치 QA는 채널별 시안을 입력으로 받는다. 채널별 시안은 최종 비주얼과 템플릿에서 나온다. 템플릿에 넣을 제목, 혜택, 제품, 날짜는 캠페인 요청을 구조화한 결과다. 파일명과 납품 목록은 승인된 채널 결과를 입력으로 받는다.
네 후보의 입출력을 이어보면 다음 흐름이 된다.
캠페인 요청 정리
→ 승인된 콘텐츠 입력
→ 템플릿 적용과 채널 변환
→ 텍스트·수치 QA와 사람의 시각 검수
→ 파일명·납품 기록
피드백 정리는 첫 프로젝트에서 후순위로 둔다. 이해관계자의 의도와 우선순위를 확정하는 일이 아직 충분히 구조화되지 않았기 때문이다.
후보를 묶을 때는 세 가지를 확인한다.
1. 앞 업무의 출력이 다음 업무의 입력이 되는가?
2. 같은 원본 데이터와 승인 상태를 공유하는가?
3. 실패했을 때 같은 수동 복구 경로로 돌아갈 수 있는가?
점수가 비슷하다는 이유만으로 연결하지 않는다.
시작점과 자동 연결의 트리거를 구분한다
프로젝트명만 넓게 적으면 실제 작업을 시작하기 어렵다. “디자인 자동화”나 “캠페인 효율화”는 무엇이 들어오고 어떤 상태에서 끝나는지 보여주지 않는다.
페블폼 프로젝트의 시작점은 비정형 캠페인 요청과 상품 원본이 도착한 상태다. 이때 요청을 목적, 제품, 날짜, 혜택, 채널, 고지문 필드로 구조화한다. 담당자가 내용을 확인하고 approved 상태로 바꾸면 자동 연결 구간의 트리거가 된다.
종료점은 채널별 결과의 사람 검수와 QA·납품 기록이다. 파일이 생성된 순간이 아니다. 사람이 제품 형태와 브랜드 조건을 확인하고, 텍스트·수치 QA를 통과한 결과가 납품 목록에 기록돼야 한다.
포함 범위는 요청 구조화, 템플릿 적용, 채널 변환, 텍스트·수치 오류 후보 표시, 파일명·납품 기록이다. 브랜드 방향 결정, 생성 방향 선택, 제품 형태·권리·법률 적합성의 최종 판정과 납품 전 시각 검수는 사람에게 남긴다.
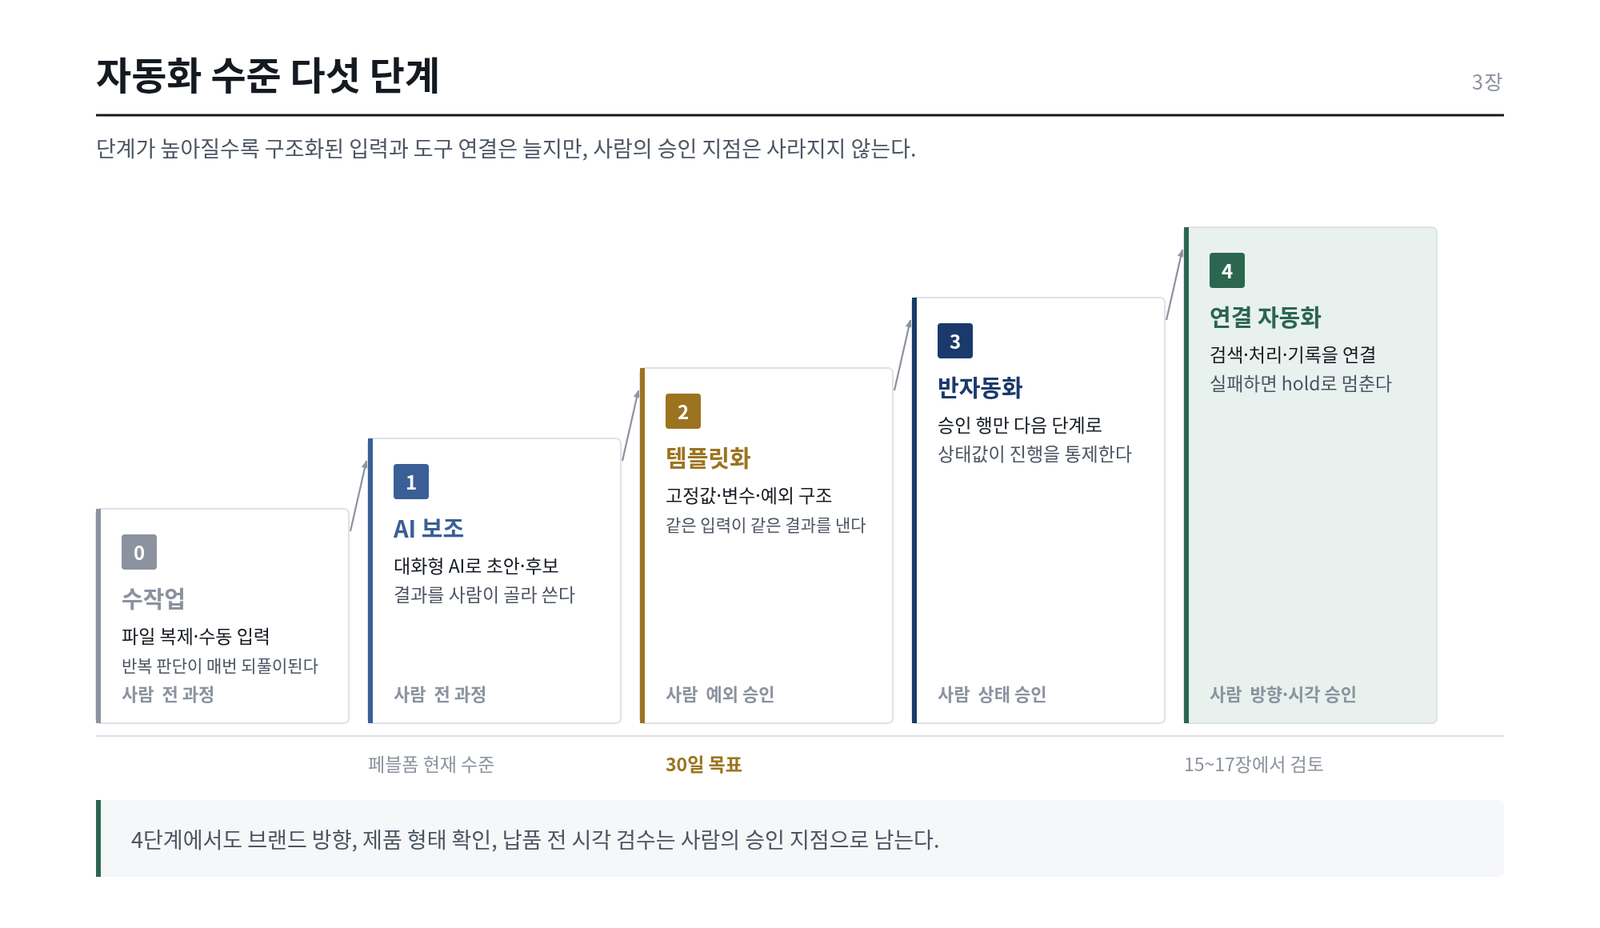
왼쪽 아래의 0단계 수작업에서 오른쪽 위의 4단계 연결 자동화까지 계단이 올라간다. 단계가 높아질수록 구조화된 입력과 도구 연결은 늘지만 사람의 승인 지점은 사라지지 않는다.
그림 2. 자동화 수준은 수작업, AI 보조, 템플릿화, 반자동화, 연결 자동화의 다섯 단계로 구분한다.
작고 되돌릴 수 있는 범위로 시험한다
첫 프로젝트는 실패를 발견하고 원래 작업으로 돌아갈 수 있는 범위가 적합하다.
NIST AI RMF Playbook은 실제 사용과 비슷한 조건에서 시스템을 시험하고 결과에 따라 경로를 수정하는 방안을 제시한다. Microsoft Research의 인간-AI 상호작용 지침도 오류를 쉽게 수정하거나 해제할 수 있어야 한다고 설명한다. 불확실한 상황에서는 범위를 줄이라고 권고한다.4
이를 업무 자동화에 제한적으로 적용하면 첫 프로젝트에는 다음 조건을 둘 수 있다.
- 한 달 안에 다시 발생하는 업무다.
- 실제 입력과 결과를 사용할 수 있다.
- 사람이 완료 여부를 확인할 수 있다.
- 실패하면
hold(보류)상태나 수작업으로 돌아갈 수 있다. - 법·권리·브랜드 최종 책임을 건너뛰지 않는다.
작게 시작한다고 성공이 보장되지는 않는다. 대신 실패 위치와 수정 비용을 확인할 수 있다. 유진은 Desk Reset Week를 포함한 캠페인 두세 건에서 같은 입력 구조와 템플릿이 작동하는지 30일 동안 시험하기로 했다.
현재 수준과 30일 목표를 나눈다
현재 페블폼은 요청문을 대화형 AI로 정리하고, 지난 Figma 파일을 복제하며, 때때로 생성형 AI로 이미지 후보를 만든다. QA와 납품 목록은 사람이 직접 확인한다. 이 책의 구분으로는 1단계 AI 보조와 파일 복제 상태다.
30일 목표는 다음으로 한정한다.
- 승인된 콘텐츠 입력 형식
- 고정값·변수·예외가 있는 템플릿
- 승인 상태를 기준으로 한 3단계 반자동화
- QA와 납품 기록
- 실패 시 보류와 수동 복구
4단계 연결 자동화는 15~17장에서 검토한다. 지금은 도구를 연결하기 전에 업무 경계를 확정한다.
첫 프로젝트 정의서는 다음과 같다.
| 항목 | 페블폼 기록 [예시] |
|---|---|
| 프로젝트명 | Desk Reset Week 반복 제작 흐름 v1 |
| 시작점 | 비정형 캠페인 요청과 상품 원본 도착 |
| 자동 연결 트리거 | 구조화된 콘텐츠 행의 approved 상태 |
| 종료점 | 채널별 결과의 사람 검수와 QA·납품 기록 |
| 포함 | 요청 구조화, 템플릿 적용, 채널 변환, 텍스트·수치 QA, 파일·납품 기록 |
| 제외 | 브랜드 방향 결정, 생성 방향 선택, 제품 형태·권리·법률 최종 판정 |
| 현재 수준 | 1단계 AI 보조 + 파일 복제 |
| 30일 목표 | 2단계 템플릿화 + 3단계 반자동화 |
| 사람 승인 | 브리프, 방향, 최종 시각 검수, 납품 |
| 실패 복구 | 보류 상태로 바꾸고 원본 담당자 또는 수작업 단계로 반환 |
구축·유지 시간을 함께 기록한다
프롤로그와 1장의 기준값을 프로젝트 정의서에 연결한다.
- 캠페인 1건 평균 작업 시간 460분 [예시]
- 평균 수정 라운드 2.8회 [예시]
- 캠페인당 오류·누락 1.7건 [예시]
- 파일 찾기·버전 확인 18분 [예시]
여기에 초기 구축 시간, 월간 유지·수정 시간, 보류·수동 복구 횟수를 더한다.
GitHub Actions 워크플로를 사용한 약 200개 프로젝트를 분석한 연구가 있다.5
결함 수정, 의존성 업데이트, 구조 개선이 주요 유지 작업으로 나타났다. 소프트웨어 개발 자동화 사례이므로 디자인 업무의 비용 수치로 옮길 수는 없다. 다만 자동화의 유지 작업을 0으로 가정하지 않아야 한다는 참고 근거가 된다.
첫 달에 채널 변환 시간이 줄어도 템플릿 수정 시간이 더 들 수 있다. 오류나 수정 라운드가 늘거나, 사람이 확인할 수 없는 단계가 생기면 범위를 줄이거나 중단한다. 중단도 운영 결과다. 자동화하지 않을 업무를 다시 분류하는 근거로 남긴다.
첫 프로젝트를 승인한다
유진은 자동화_후보_우선순위_v1에 네 후보의 계산값과 판정 근거를 남겼다. 가장 높은 파일 정리 하나를 선택하지 않고, 요청 정리부터 QA·납품 기록까지 하나의 입력·출력 흐름으로 묶었다.
첫_프로젝트_정의서_v1에는 프로젝트 시작점과 자동 연결 트리거, 종료점, 포함·제외 범위, 사람 승인, 수동 복구, 측정값이 들어 있다.
아직 템플릿이나 도구 연결은 만들지 않았다. 4장에서는 사람에게 남긴 브랜드 방향 판단이 실제로 어떤 선택으로 이루어져 있는지 과거 디자인에서 찾는다.
이번 장에서 완성한 것
자동화_후보_우선순위_v1에는 제외 조건을 먼저 적용한 후보 점수와 연결 관계가 기록돼 있다.
첫_프로젝트_정의서_v1에는 시작점, 자동 연결 트리거, 종료점과 포함·제외 범위가 들어 있다. 현재·목표 수준, 승인, 수동 복구, 측정·중단 기준도 함께 기록돼 있다.
다음 장에서 사용하는 방법
4장에서는 페블폼의 만족작과 문제작 여덟 개를 펼친다. 사람이 맡기로 한 브랜드 방향 판단이 어떤 반복 선택으로 구성돼 있는지 비교한다.
4. NIST AI RMF Playbook; Saleema Amershi et al., “Guidelines for Human-AI Interaction,” CHI 2019. 두 자료가 디자인 자동화 프로젝트의 크기를 직접 규정하는 것은 아니며, 시험·수정·범위 축소 원칙만 참고한다.
5. Pablo Valenzuela-Toledo et al., “The Hidden Costs of Automation: An Empirical Study on GitHub Actions Workflow Maintenance,” 2024 IEEE International Conference on Source Code Analysis and Manipulation (SCAM), pp. 213–223, DOI 10.1109/SCAM63643.2024.00029. 디자인 자동화의 유지 비용 수치로 일반화하지 않는다.