인터뷰 녹취록에서 ‘불안’이라는 낱말을 찾으면 그 낱말이 든 발화가 몇 개인지는 바로 셀 수 있습니다. 하지만 이 수는 불안을 이야기한 발화의 수와 같지 않습니다. “걱정돼요”, “손이 떨렸어요”처럼 낱말 없이 같은 이야기를 하는 발화가 있고, “불안하지 않아요”처럼 낱말은 있으나 반대를 말하는 발화도 있기 때문입니다. 질적 연구에서는 녹취록의 발화를 주제별로 나누고 이름표를 붙이는 일을 코딩이라 하고, 그 이름표를 코드, 코드와 그 뜻을 적어 둔 표를 코드표라 합니다. 발화는 한 사람이 이어서 말한 한 덩어리를 가리킵니다.
가상의 누리대학교 교육대학원 석사과정 문채원 씨는 학위논문을 위해 신규 교사 8명을 인터뷰했습니다. 참여자는 T01~T08 번호로 부르고, 인터뷰마다 질문은 같은 여덟 개입니다. 이 장의 녹취록은 발화를 줄여 만든 가상 자료이고, 8명의 발화를 모두 합하면 160개입니다. 문채원 씨가 알고 싶은 것은 신규 교사 가운데 ‘불안·걱정’을 말한 발화가 몇 개이고 말한 사람이 몇 명인가입니다. 발화 160개를 일일이 코딩하는 데는 시간이 많이 들고, 실제 논문의 녹취록은 이보다 훨씬 깁니다. 그래서 코드표는 문채원 씨가 정하고, 발화마다 코드를 다는 일은 클로드가, 세는 일은 엑셀이 맡고, 결과는 다시 문채원 씨가 표본으로 확인합니다.
 이 장에서 다루는 것
| 이런 분께 | 인터뷰나 주관식 응답을 주제별로 나누어 세어야 하는 대학원생·연구자 |
| 진행 방식 | ① 대화창 — 녹취록 파일을 첨부해 코드표 초안과 발화별 코딩을 받고, 코드표 확정과 표본 검토는 연구자가, 집계·표본 뽑기·검산은 엑셀 수식으로 |
| 준비 파일 | 가상 신규 교사 인터뷰 8명의 참여자 목록·질문 목록·녹취록(발화 160개)이 든 엑셀 파일 한 개 |
| 완성 파일 | 요약·참여자·녹취록·코드표·코딩·집계·표본검토·인용목록·초안·검산(15줄) 시트가 든 파일 |
| 엑셀 기능 | COUNTIF, COUNTIFS, COUNTA, SEARCH, ISNUMBER, IF, AND, RAND, RANK, INDEX, MATCH, IFERROR, SUMPRODUCT, ABS, SQRT, 조건부 서식 |
| 쓰는 도구 | 클로드 대화창(파일 첨부)과 엑셀 |
| 핵심 키워드 | 코드표 · 발화 단위 코딩 · 발화 수와 말한 사람 수 · 표본 일치율 · 참여자 식별 정보 · 검산 |
| 난이도 | ●●○ 통합 — 코드표 확정과 표본 검토는 연구자가, 코딩 초안과 집계 식은 클로드와 엑셀이 맡습니다 |
 먼저 답부터
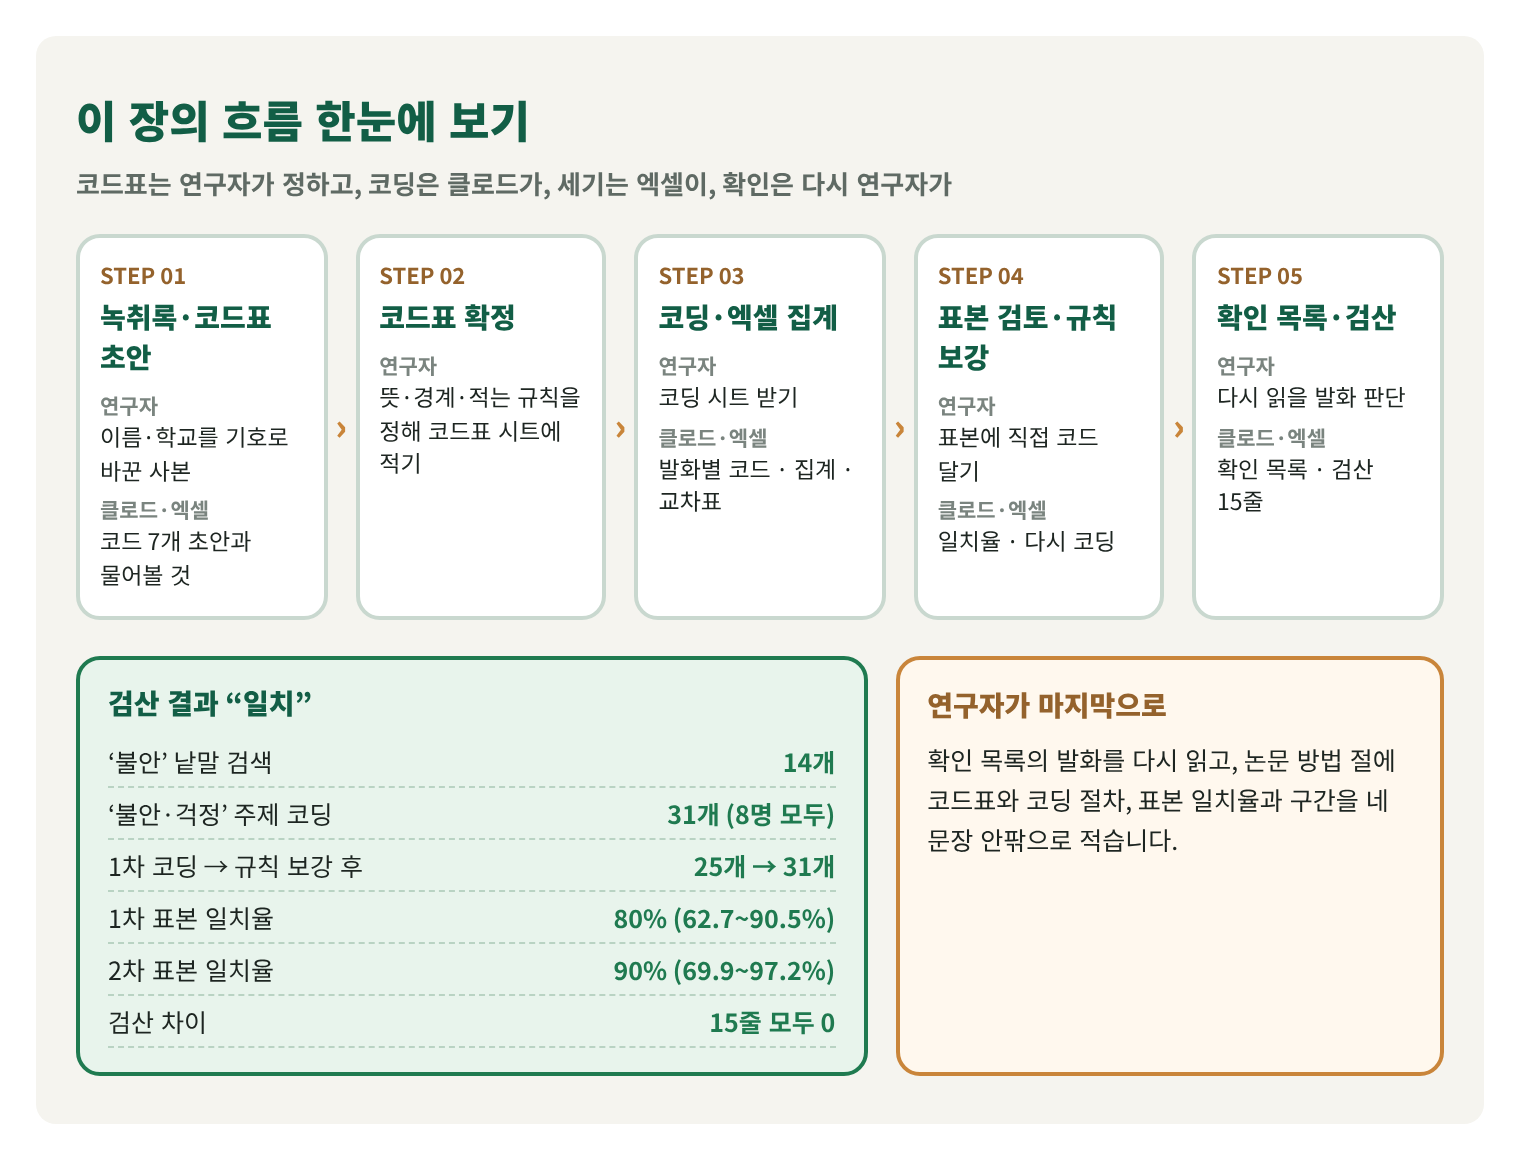
셀 수 있습니다. 코드표를 정하는 사람은 연구자이고, 클로드는 그 코드표대로 발화마다 코드를 달며, 엑셀이 코드별 발화 수와 말한 사람 수를 셉니다. 이 사례에서 ‘불안’ 낱말은 14개 발화에 있었고, ‘불안·걱정’ 주제로 코딩하니 31개 발화였습니다. 클로드가 단 코드는 표본으로 확인해야 합니다. 첫 표본 30개의 일치율은 80.0%였고, 규칙을 보강한 뒤 새 표본 20개의 일치율은 90.0%였습니다. 논문 표에 옮기기 전에는 연구자가 확인할 발화를 목록으로 받고, 열다섯 줄의 검산으로 집계가 맞는지 봅니다. 가상 자료의 값입니다.
SECTION 25-1
25-1 ‘불안’을 검색한 값과 코딩한 값
이 장의 대학, 인물, 학교, 발화는 모두 가상입니다. 코드표의 코드와 표본의 크기처럼 사례를 위해 정한 값은 본문에서 따로 밝혔습니다.
녹취록 시트는 인터뷰 8건을 이어 붙인 표입니다. 열은 번호, 인터뷰, 화자, 질문, 발화ID, 내용이고, 연구자의 질문 행에는 발화ID가 없습니다. 발화ID는 참여자의 발화에만 U001부터 U160까지 붙였습니다. 문채원 씨가 가장 먼저 한 일은 코딩 시트에 발화를 옮기고 COUNTIF로 ‘불안’이 든 발화를 세는 것이었습니다. 초안 시트 B5의 식은 =COUNTIF(코딩!$D$5:$D$164,”*불안*”)입니다. 식에서 별표(*)는 앞뒤에 무엇이 와도 된다는 와일드카드이므로 ‘*불안*’은 ‘불안’이 들어 있는 칸을 모두 셉니다. 결과는 14입니다.
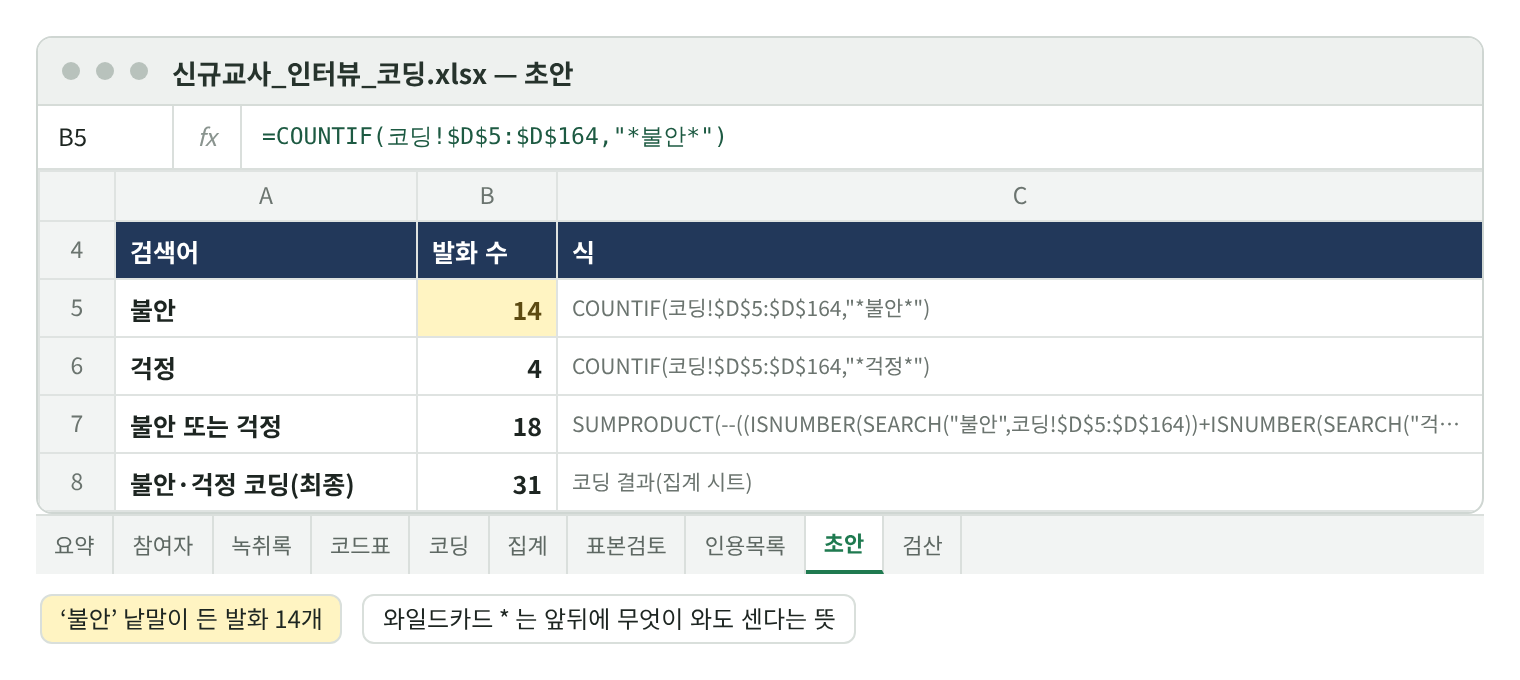
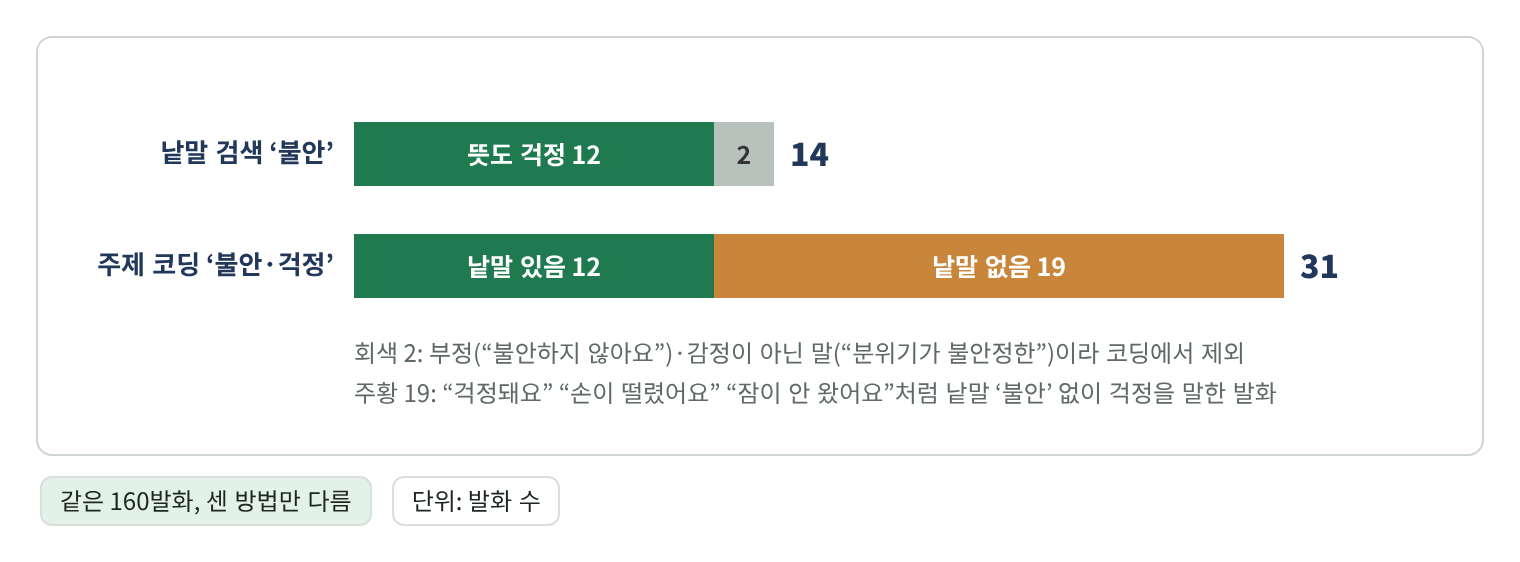
문채원 씨는 14가 적다고 보았습니다. 인터뷰를 직접 했으므로 신규 교사 대부분이 불안을 이야기했다고 기억했기 때문입니다. 14개 발화를 하나씩 읽어 보니 두 개는 불안을 말하는 발화가 아니었습니다. U096은 “아이들과는 오히려 불안하지 않아요”이고, U144는 “학급 분위기가 불안정한 날이 많아서”입니다. 앞의 것은 부정이고, 뒤의 것은 교실의 상태를 가리킵니다. 낱말이 있어도 걱정을 말하지 않은 발화이므로, 걱정을 말한 발화는 12개입니다.
반대로 낱말 검색이 놓친 발화는 더 많았습니다. “퇴근하고 집에 와도 내일 수업은 괜찮을까 걱정이 돼서 잠이 잘 안 왔어요”(U001)와 “그 뒤로 전화벨이 울리면 가슴이 철렁해요”(U011)에는 ‘불안’이 없습니다. “아직도 매일 아침 출근길이 두려워요”(U125), “현장학습 전날에는 혹시 사고라도 날까 봐 밤새 걱정했어요”(U109)도 마찬가지입니다. 이렇게 낱말 없이 걱정을 말한 발화가 19개 있었습니다. 규칙 보강까지 마친 최종 코딩으로 뜻에 따라 센 ‘불안·걱정’은 12 + 19 = 31개 발화이고, 8명이 모두 이 주제를 말했습니다. 규칙 보강 전의 1차 코딩은 STEP 3과 STEP 4에서 다룹니다.
 코딩에서 알아 둘 것
코딩에서 조심할 점은 세 가지입니다. 첫째, 같은 주제를 다르게 말합니다. 위의 걱정은 “걱정돼요”, “두려워요”, “가슴이 철렁해요”, “마음에 걸려요”로 나타나므로 낱말 목록을 아무리 늘려도 놓치는 발화가 생깁니다. 둘째, 한 발화에 주제가 둘 이상 있습니다. U010 “학부모님이 전화를 주셨는데, … 제가 뭐라고 대답해야 할지 몰라서 손이 떨렸어요”는 학부모·민원 이야기이면서 걱정 이야기입니다. 한 코드만 달 수 있게 하면 둘 중 하나가 사라지므로, 이 사례에서는 한 발화에 코드를 최대 3개까지 달기로 했습니다.
셋째, 인터뷰 자료에는 참여자를 알아볼 수 있는 정보가 들어 있습니다. 학교 이름, 동료 교사의 이름, 학교급과 연차를 함께 적은 표현이 그런 정보입니다. 이 장의 녹취록에서는 학교와 사람 이름을 [A초], [B중], [멘토 교사], [학년 부장]처럼 기호로 바꾸어 두었습니다. 참여자가 8명뿐이면 학교급과 연차만으로 누구인지 짐작될 수 있으므로, 보고서에는 참여자 번호를 쓰고 학교급과 연차는 묶어서 적는 편이 안전합니다.
센 결과를 읽을 때 알아 둘 점도 두 가지입니다. 하나는 발화 수와 말한 사람 수가 다르다는 점입니다. 이 사례의 불안·걱정 발화 31개는 8명이 나누어 말한 것이고, 참여자별로는 3~5개입니다. 논문에는 대개 두 수를 모두 적습니다. 다른 하나는 한 발화에 코드가 둘 이상이면 코드별 발화 수를 모두 더한 값이 전체 발화 수보다 커진다는 점입니다. 이 장의 집계에서는 코드별 발화 수의 합이 227이고 전체 발화는 160개입니다. 같은 이유로 코드별 발화 비율을 모두 더하면 100%를 넘습니다.
엑셀왕 노트 자료를 올리기 전에 확인할 것
녹취록에는 참여자의 이야기가 들어 있습니다. 외부 AI 서비스에 올려도 되는지는 소속 기관의 연구윤리 규정과 참여자가 서명한 동의서에 따라 달라지므로, 올리기 전에 확인합니다. 올리기로 했다면 이름과 학교 같은 식별 정보는 먼저 기호로 바꾸고, 대응표는 올리지 않습니다. 이 장의 자료는 가상이라 이 확인이 필요하지 않았습니다.
SECTION 25-2
25-2 녹취록 정리에서 검산까지 다섯 단계
예제 zip의 ‘원본’ 폴더에 ‘신규교사_인터뷰_녹취록.xlsx’가 들어 있습니다. 참여자, 질문, 녹취록 세 시트이고 발화는 모두 가상입니다. 이 파일을 대화창에 첨부해 순서대로 따라 합니다. 코드표는 연구자가 확정하고, 표본 검토에서 나온 불일치로 코드표의 규칙을 한 번 보강합니다.
 클로드에서는 대화창에 파일을 첨부해 코딩 맡기기
Claude 도움말 ‘파일 업로드’(2026년 10월 31일 확인)에 따르면 채팅에서는 한 파일에 500MB까지, 한 채팅에 파일 20개까지 올릴 수 있고 CSV와 XLSX를 지원합니다. XLSX를 올리려면 코드 실행과 파일 생성 기능이 켜져 있어야 하며, PDF가 아닌 문서에서는 글자만 읽습니다. 파일 생성 기능이 켜져 있으면 요청에 따라 코딩 시트를 더한 새 엑셀 파일을 만들어 내려받게 해 줍니다. 이 장의 파일은 시트 세 장짜리 작은 XLSX 하나입니다.
올린 파일의 내용은 대화에 담겨 클로드 쪽으로 보내져 처리됩니다. 녹취록은 참여자에게서 받은 이야기이므로 앞의 상자에서 말한 확인을 먼저 하고, 이름과 학교를 기호로 바꾼 사본만 올립니다. 같은 요청을 다시 보내도 코드가 똑같이 나온다는 보장은 없어서 표본 검토를 코딩 뒤에 둡니다. 이 글의 답변은 재현이라 실제 답과 다를 수 있으니, 받은 파일은 STEP 4의 표본 검토와 STEP 5의 검산 시트로 확인합니다.
STEP 1 녹취록을 정리하고 코드표 초안 받기
인터뷰 파일(워드나 한글 문서)의 내용을 엑셀의 녹취록 시트로 옮깁니다. 열은 번호, 인터뷰, 화자, 질문, 발화ID, 내용입니다. 연구자의 질문과 참여자의 발화를 한 행씩 나누어 적고, 참여자의 발화에만 발화ID를 붙입니다. 코드를 달 때 클로드가 가리킬 수 있는 이름표가 필요하기 때문입니다.
이름과 학교는 이 단계에서 기호로 바꿉니다. 찾아 바꾸기로 학교 이름은 [A초], [B중]으로, 동료 교사는 [멘토 교사], [학년 부장], [교감], [동 학년 교사]로 바꾸고, 바꾼 규칙은 연구자의 파일에만 둡니다. 이 장의 녹취록은 처음부터 기호로 적었습니다. 정리한 파일을 대화창에 첨부하고 코드표 초안부터 받습니다.
 이렇게 말하기
첨부한 파일의 녹취록 시트에 신규 교사 8명 인터뷰가 있어. 질문은 신규 교사가 학교에서 겪는 어려움이야. 주제별로 나눌 코드표 초안을 만들어 줘. 코드마다 뜻과 예시 발화ID를 적고, 정하지 못한 건 물어봐 줘. 답에 들어가야 할 내용
· 녹취록 시트의 참여자 발화를 읽고, 자주 나오는 주제를 코드로 묶습니다.
· 코드마다 이름과 뜻, 예시 발화ID를 적은 코드표 초안을 보여 줍니다.
· 한 발화에 코드를 몇 개까지 달지처럼 연구자가 정해야 할 것을 질문으로 남깁니다.
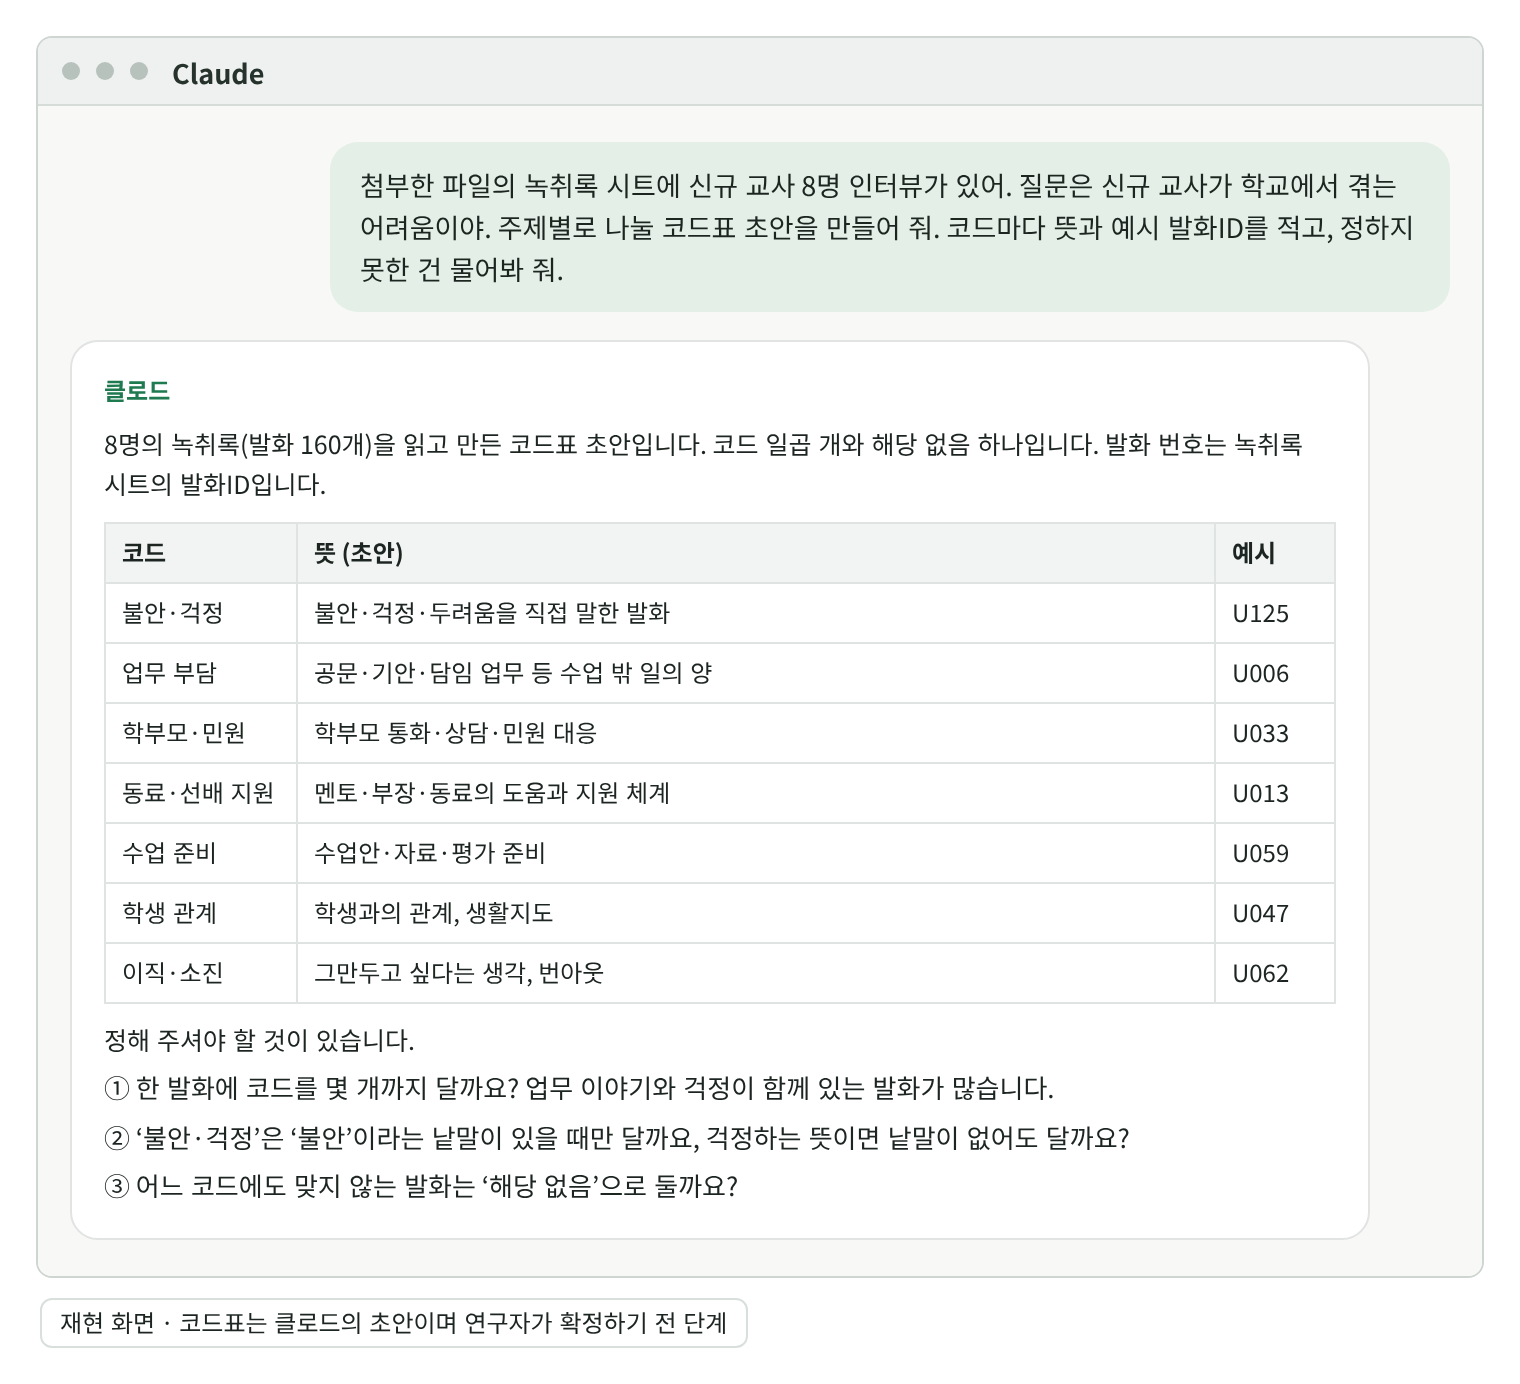
재현 화면의 초안은 일곱 개 코드와 질문 세 가지입니다. 초안은 읽고 고칠 재료로 씁니다. 초안의 코드가 연구 질문과 맞는지, 이론이나 선행연구에서 가져와야 할 코드가 빠지지 않았는지는 연구자가 판단합니다. 주제 분석의 단계를 설명한 Braun과 Clarke(2006)는 코드가 자료에서 나오는 방식과 이론에서 오는 방식을 구분하며, 이 장은 자료를 읽고 만든 초안을 연구자가 확정한 뒤, 고정한 코드표를 발화에 적용하는 방식입니다.
 STEP 2 코드표 확정하기
클로드가 남긴 질문 세 가지는 문채원 씨가 정했습니다. 첫째, 한 발화에 코드는 최대 3개까지 달고 코드표 순서대로 적습니다. 둘째, 걱정하는 뜻이면 낱말이 없어도 ‘불안·걱정’을 답니다. 셋째, 어느 코드에도 맞지 않는 발화는 ‘해당 없음’으로 두고 다른 코드와 함께 달지 않습니다.
코드표는 녹취록 파일에 ‘코드표’ 시트를 새로 만들어 연구자가 직접 적고, 이 파일을 다시 첨부해 STEP 3을 요청합니다. 코드표 시트에는 코드마다 이름, 뜻, 이런 말이 나오면, 경계를 적습니다. 경계 칸은 비슷한 코드 사이의 선을 긋는 곳입니다. 예를 들어 ‘수업 준비에 드는 시간’은 수업 준비 코드로 달고, 학부모가 낀 생활지도 이야기는 학생 관계와 학부모·민원을 함께 답니다.
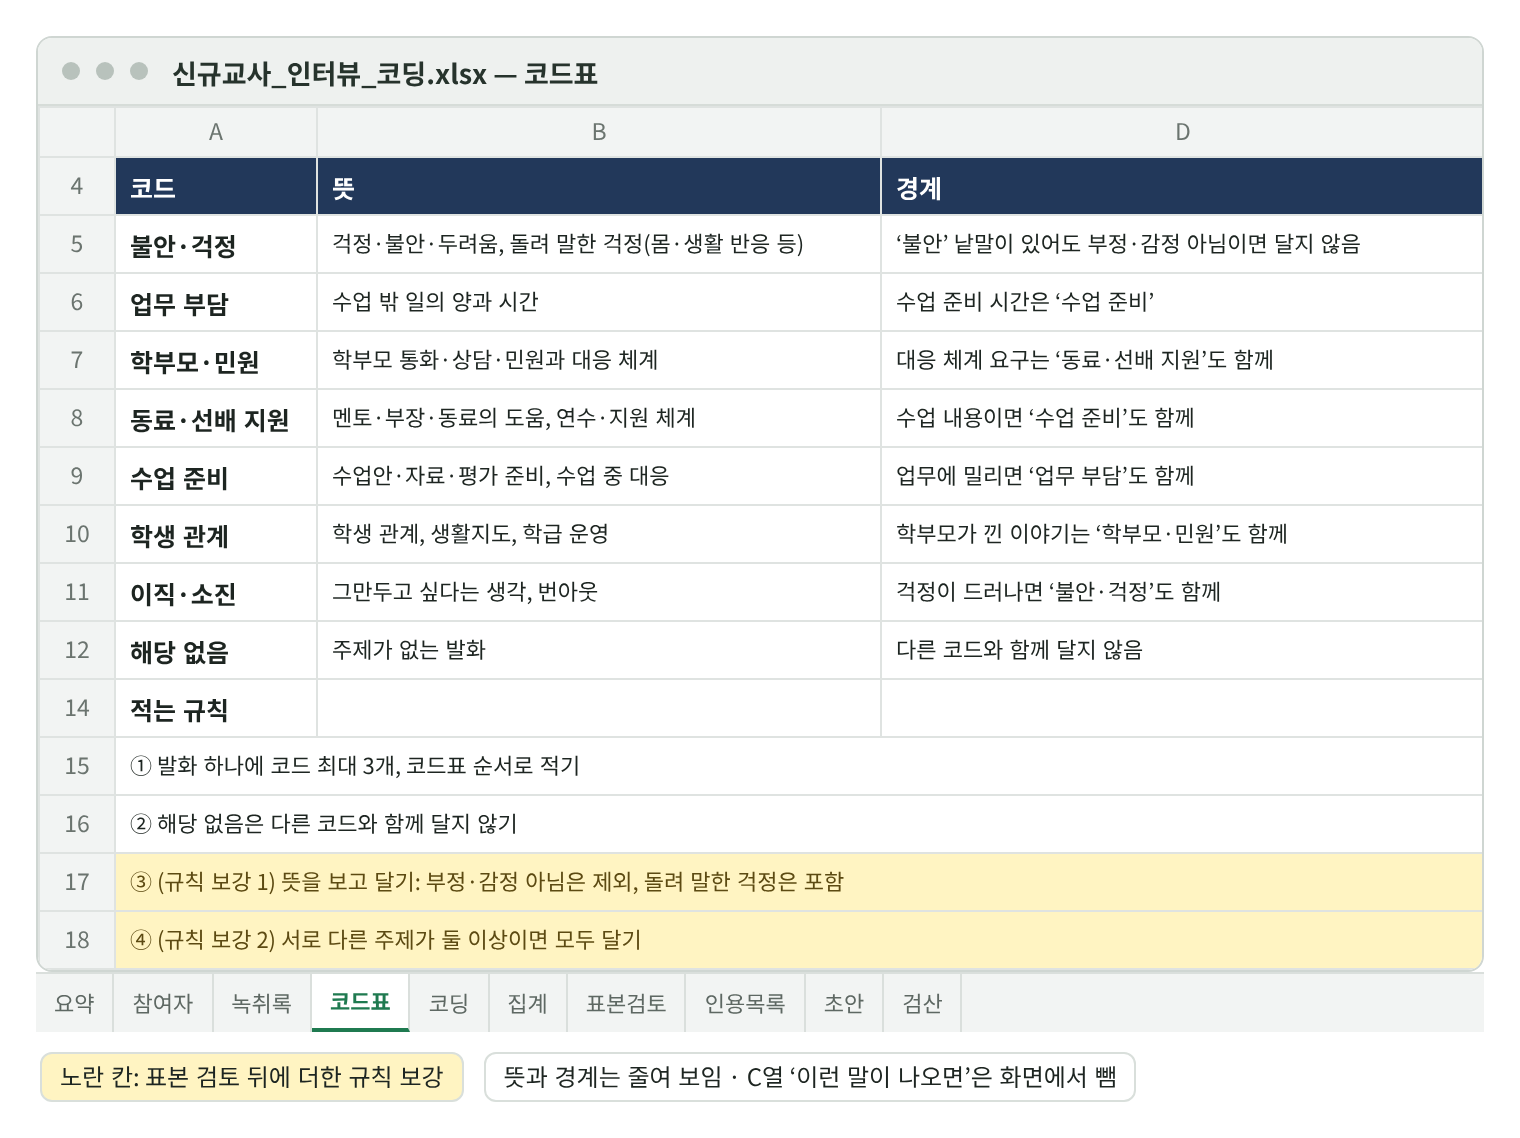
화면의 코드표는 규칙 보강까지 끝난 최종본입니다. STEP 4에서 더한 두 줄이 노란 칸입니다. 처음에 문채원 씨가 확정한 코드표에는 이 두 줄이 없었습니다.
STEP 3 코딩을 맡기고 엑셀로 세기
이렇게 말하기
코드표 시트의 코드표대로 녹취록 시트의 참여자 발화에 코드를 달아 줘. 발화 하나에 코드는 최대 3개이고 코드표 순서로 적어. 연구자 질문 행은 건너뛰어. 결과는 코딩 시트로 만들어 줘. 열은 발화ID, 참여자, 질문, 발화, 코드1, 코드2, 코드3이야.답에 들어가야 할 내용
· 코드표의 뜻과 경계에 따라 발화 160개에 코드를 단 코딩 시트(발화ID, 참여자, 질문, 발화, 코드1~3)를 파일로 돌려줍니다.
· 연구자 질문 행은 건너뛰고, 코드는 코드표 순서로 최대 3개까지 적습니다.
· 판단이 애매한 발화는 따로 알려 달라고 하면 목록으로 알려 줍니다.
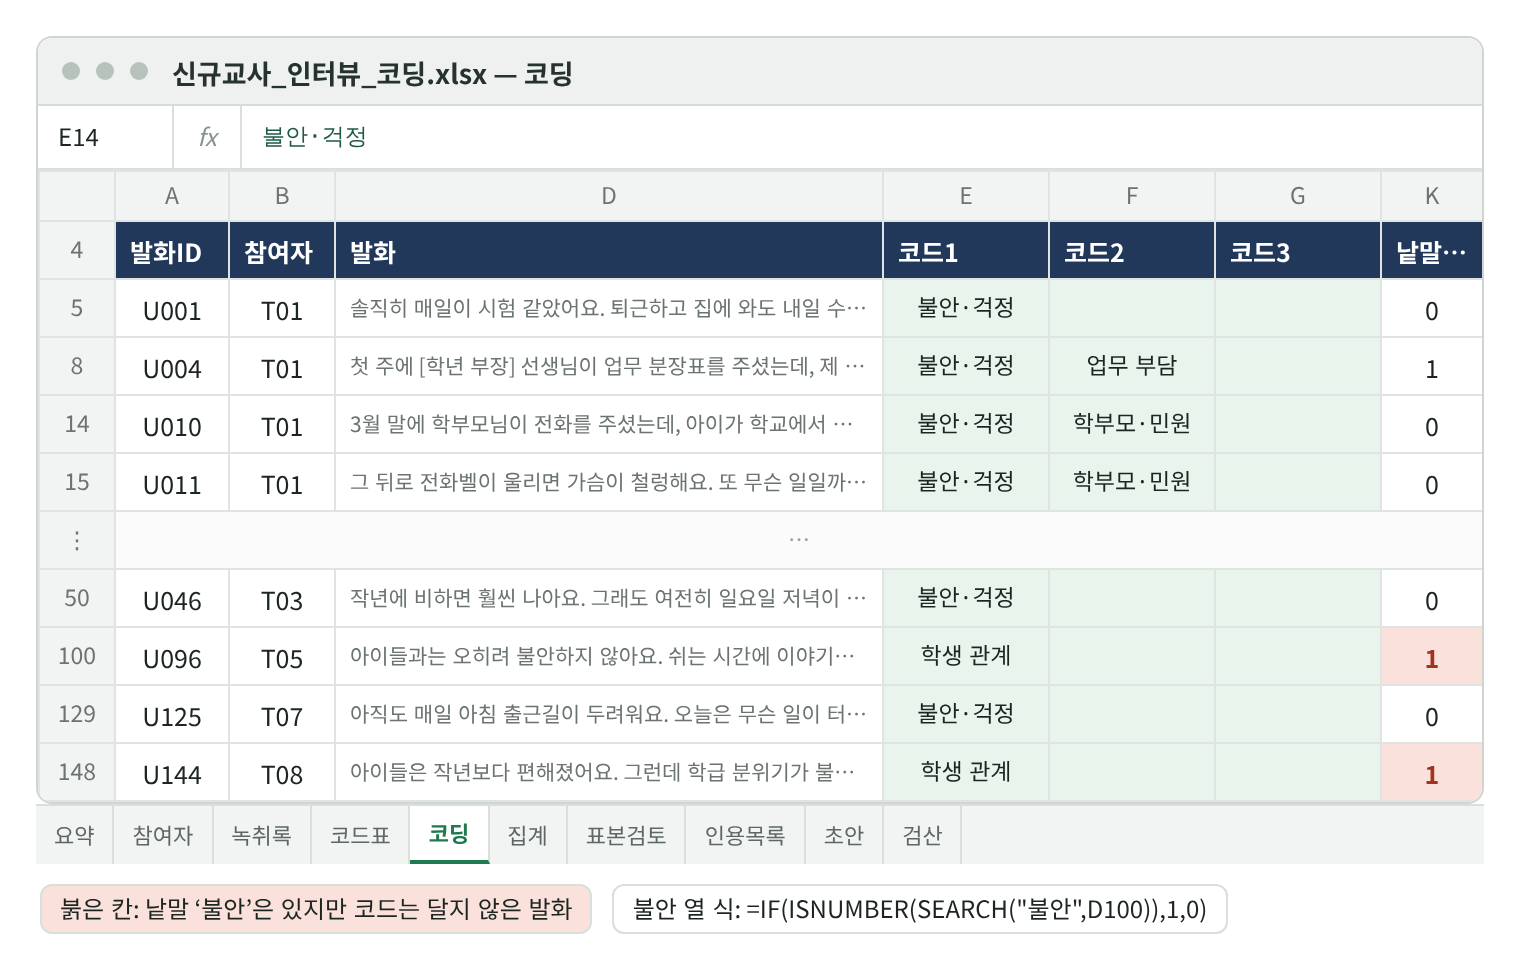
돌려받은 파일의 코딩 시트에 열을 하나 더했습니다(완성 파일에서는 1차 코드 H~J열 뒤의 K열). K열은 낱말 ‘불안’이 들어 있는지를 0과 1로 적은 열로, 낱말 검색과 코딩을 같은 표에서 견주기 위해서입니다. K열에는 낱말은 있는데 불안·걱정 코드가 없는 발화를 붉게 칠하는 조건부 서식을 걸었습니다.
 수식 한 줄 읽기 코딩 K5
=IF(ISNUMBER(SEARCH("불안",D5)),1,0)· SEARCH(“불안”,D5)는 D5의 발화에서 ‘불안’이 시작되는 위치를 찾고, 없으면 오류를 돌려줍니다.
· ISNUMBER가 위치(숫자)인지 확인해 참·거짓으로 바꾸고, IF가 참이면 1, 아니면 0으로 바꿉니다.
코드별로 세는 식은 집계 시트에 있습니다. 코드는 코드1~3 세 칸 어디에든 올 수 있으므로 COUNTIF의 범위를 세 칸 전체(E5:G164)로 잡습니다.
수식 한 줄 읽기 집계 B5
=COUNTIF(코딩!$E$5:$G$164,A5)· A5에는 ‘불안·걱정’ 같은 코드 이름이 있고, 코딩!E5:G164는 세 코드 칸 전체입니다.
· 한 발화에 같은 코드를 두 번 달지 않는다는 전제에서 칸의 개수가 곧 발화의 개수입니다. 이 전제는 검산 시트가 확인합니다.
말한 사람 수는 참여자별 교차표(참여자 × 코드로 발화 수를 세어 놓은 표)에서 셉니다. 교차표의 한 칸은 해당 참여자의 발화 가운데 그 코드가 세 칸 중 하나에 있는 발화의 수이고, 발화가 하나라도 있는 참여자를 세면 말한 사람 수입니다.
수식 한 줄 읽기 집계 B18
=COUNTIFS(코딩!$B$5:$B$164,$A18,코딩!$E$5:$E$164,B$17)+COUNTIFS(코딩!$B$5:$B$164,$A18,코딩!$F$5:$F$164,B$17)+COUNTIFS(코딩!$B$5:$B$164,$A18,코딩!$G$5:$G$164,B$17)· 코드1, 코드2, 코드3 칸을 각각 COUNTIFS로 세어 더합니다. B17에는 열 제목(코드 이름)이 있어 식을 오른쪽으로 끌어 쓸 수 있습니다.
· 말한 사람 수는 집계 D5의 =COUNTIF(B18:B25,”>0″)으로 구합니다. 교차표 열에서 발화가 하나라도 있는 참여자(0보다 큰 칸)를 세는 식이고, 다른 코드는 열을 옮겨 같은 식을 씁니다.
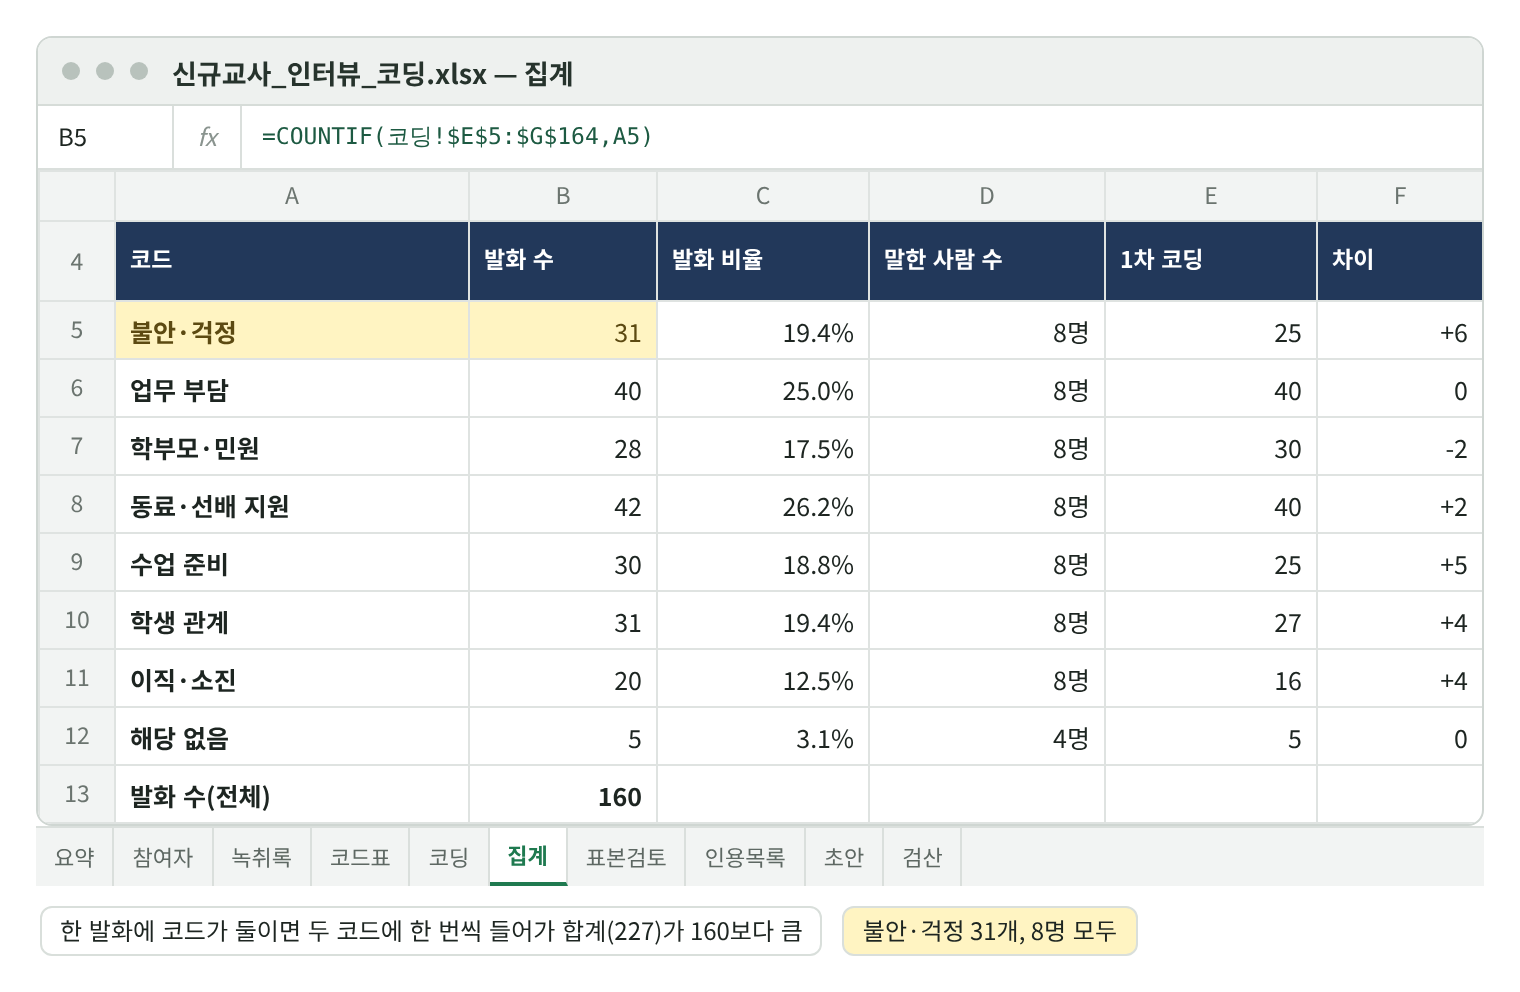
집계 시트에는 규칙 보강 전의 1차 코딩 값이 나란히 있습니다. 1차 코딩에서 불안·걱정은 25개였고, 규칙을 보강한 뒤 31개가 되었습니다. 코드 7개의 말한 사람 수는 모두 8명이고, ‘해당 없음’만 4명입니다. 한 코드가 한두 명에게만 몰려 있지 않다는 것은 이 가상 자료의 특징입니다.
 STEP 4 표본으로 확인하고 규칙 보강하기
클로드가 단 코드를 160개 모두 다시 읽을 수는 없으므로, 무작위로 뽑은 표본에 연구자가 직접 코드를 달아 클로드의 코드와 견줍니다. 코딩 시트의 L열에 RAND()로 난수를 만든 뒤 값으로 붙여 넣어 고정하고, M열에서 난수가 작은 순서대로 1~30위는 1차 표본, 31~50위는 2차 표본으로 표시합니다. 표본의 크기 30과 20은 사례를 위해 정한 값입니다. 난수를 값으로 붙여 넣는 까닭은 RAND가 시트가 다시 계산될 때마다(셀을 고치거나 파일을 열 때) 새 값을 만들어 표본이 바뀌기 때문입니다. 난수를 반올림하지 말고 그대로 붙여 넣어야 순위가 겹치지 않으며, 표본의 크기는 검산 시트가 확인합니다.
수식 한 줄 읽기 코딩 M5
=IF(RANK(L5,$L$5:$L$164,1)<=30,1,IF(RANK(L5,$L$5:$L$164,1)<=50,2,""))· RANK(L5, 범위, 1)은 L5가 작은 쪽에서 몇 번째인지 알려 줍니다.
· 30위 이하면 1, 50위 이하면 2를 적고, 나머지는 빈 칸으로 둡니다.
연구자는 표본 발화에 클로드의 코드를 보지 않고 코드를 답니다. 표본검토 시트에는 연구자 코드와 클로드 코드를 나란히 두고 두 코드 집합이 완전히 같으면 ‘일치’로 봅니다. 한 코드만 달라도 불일치입니다. F열의 식은 두 칸의 글자를 그대로 비교하므로, 연구자 코드도 코드표 순서로 ‘/’를 넣어 적습니다. 이 사례에서 연구자 코드는 사례를 위해 정한 값입니다.
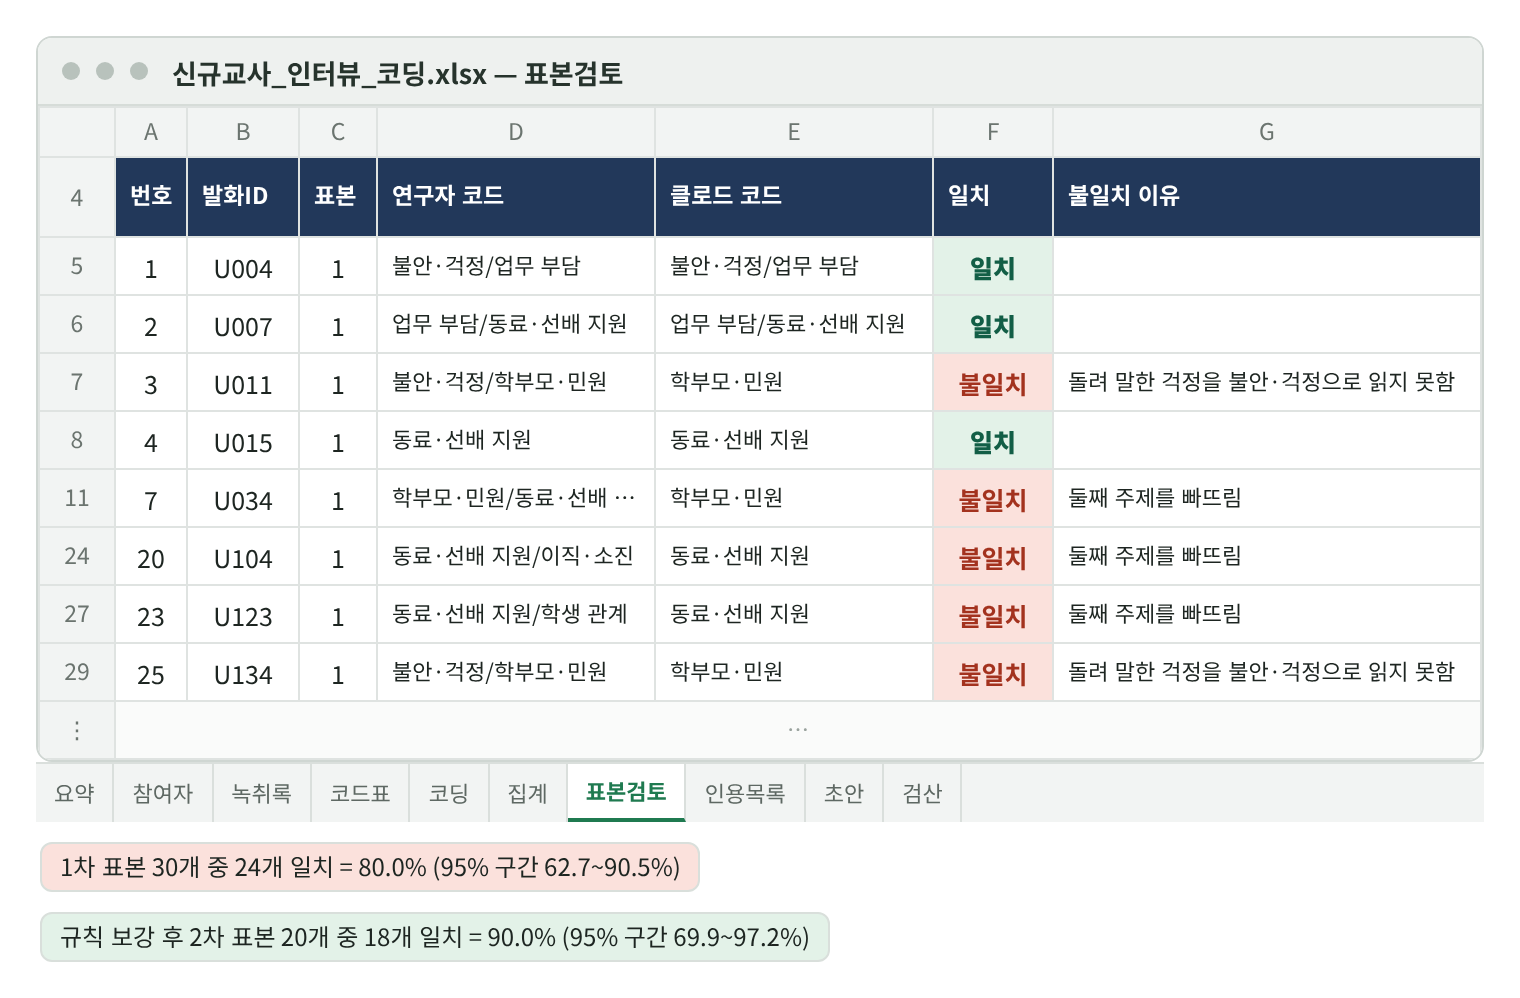
1차 표본 30개 가운데 24개가 일치해 일치율은 80.0%였습니다. 불일치 6개는 세 종류입니다. 돌려 말한 걱정을 읽지 못한 발화가 둘(U011 “가슴이 철렁해요”, U134 “계속 마음에 걸려요”), 둘째 주제를 빠뜨린 발화가 셋(U034, U104, U123), ‘불안’ 낱말만 보고 코드를 단 발화가 하나(U144 “분위기가 불안정한”)입니다. 세 종류 모두 코드표에 규칙 한두 줄을 더하면 줄일 수 있는 오류였습니다.
문채원 씨는 코드표에 두 줄을 더했습니다. 첫째 줄은 ‘낱말보다 뜻을 보되 부정(“불안하지 않아요”)이거나 사람의 감정이 아니면(“분위기가 불안정해요”) 달지 않고, 걱정을 돌려 말한 표현은 불안·걱정으로 단다’이고, 둘째 줄은 ‘한 발화에 서로 다른 주제가 둘이면 모두 단다’입니다. 보강한 코드표로 클로드에게 160개를 다시 코딩하게 했고, 그 결과가 앞의 집계 화면의 값입니다.
이렇게 말하기
코드표 시트에 규칙 두 줄을 더했어. 낱말보다 뜻을 보고, 한 발화에 주제가 둘이면 모두 달아 줘. 코드표 순서와 최대 3개는 그대로야. 같은 방식으로 코딩 시트를 다시 만들어 줘. 앞의 코딩은 1차 코드 열로 남겨 줘.보강한 규칙은 1차 표본의 불일치를 보고 만든 것이므로, 같은 30개로 다시 재면 일치율이 높게 나오기 쉽습니다. 그래서 처음 보는 2차 표본 20개로 다시 확인했고, 일치는 18개, 일치율은 90.0%였습니다. 불일치 두 개는 주제를 하나 더 단 것(U057)과 둘째 주제를 빠뜨린 것(U058)입니다. 일치율은 표본 값이라 오차가 있습니다. 신뢰구간은 표본이 작을 때 일치율이 어느 정도 범위에 있을 수 있는지를 보여 주는 값이고, 여기서는 윌슨 방식(표본검토 시트 K8:L9의 식)으로 95% 신뢰구간을 계산했습니다. 구간은 1차가 62.7~90.5%, 2차가 69.9~97.2%로 두 구간이 많이 겹쳐서, 이 표본만으로는 일치율이 올랐다고 말하기 어렵습니다. 표본이 작으면 일치율은 대략의 범위로만 말할 수 있습니다. 이 일치율은 코드 집합이 완전히 같은 발화의 비율입니다. 우연한 일치를 보정한 코더 간 신뢰도 지표(카파 등)가 필요하면 따로 계산합니다.
일치율을 어떤 수준 이상이어야 한다고 정해 둔 절대 기준은 없습니다. 질적 연구에서 코더 간 일치를 어떻게 다룰지는 O’Connor와 Joffe(2020)가 논쟁과 실무 지침으로 정리했습니다. 대규모 언어 모델에 코드북을 주고 연역적 코딩을 시킨 연구로는 Xiao 외(2023)가 있고, 전문가 코딩과 약간(fair)에서 상당한(substantial) 수준의 일치도를 보였다고 보고했습니다. 이 장의 값은 이 가상 자료의 값이며, 실제 연구에서는 자료와 코드표마다 표본으로 확인합니다.
 엑셀왕 TIP 표본에서 불일치가 나오면
불일치를 하나씩 읽고 종류를 나누면 어디를 고칠지 보입니다. 코드표의 뜻이 모호해서 생긴 불일치는 코드표를 고칩니다. 클로드가 읽다 놓친 불일치는 같은 종류가 여러 번 나오면 규칙을 더 구체적으로 적고, 한두 번이면 코드표를 그대로 두고 연구자가 해당 발화의 코드를 직접 고칩니다. 코드표를 고친 뒤에는 새 표본으로 다시 잽니다.
보고서에 넣을 인용 고르기
코딩이 끝나면 코드마다 대표 인용을 고릅니다. 연구자가 코딩 시트의 N열에 코드 이름을 적으면, O열이 코드별 순번을 붙여 ‘불안·걱정|1’ 같은 인용키를 만들고, 인용목록 시트가 INDEX·MATCH로 그 발화를 불러옵니다. 인용은 참여자가 알아볼 만한 내용이 없는지 연구자가 한 번 더 읽고 고릅니다.
수식 한 줄 읽기 인용목록 C5
=IFERROR(INDEX(코딩!$B$5:$B$164,MATCH(F5,코딩!$O$5:$O$164,0)),"")· F5는 코드 이름과 순번을 붙인 인용키(불안·걱정|1)이고, MATCH가 코딩 시트 O열에서 같은 인용키가 있는 행을 찾습니다.
· INDEX가 그 행의 참여자(B열)를 가져옵니다. 인용키가 없으면 IFERROR가 빈 칸으로 둡니다.
 STEP 5 확인 목록 받고 검산하기
집계를 논문 표에 옮기기 전에, 연구자가 녹취록을 다시 읽어 확인할 발화를 클로드에게 추리게 합니다. 읽고 판단하는 일은 연구자가 합니다.
이렇게 말하기
집계를 논문 표에 옮기기 전에 내가 직접 다시 읽어야 할 발화를 알려 줘. 코드는 아직 고치지 마.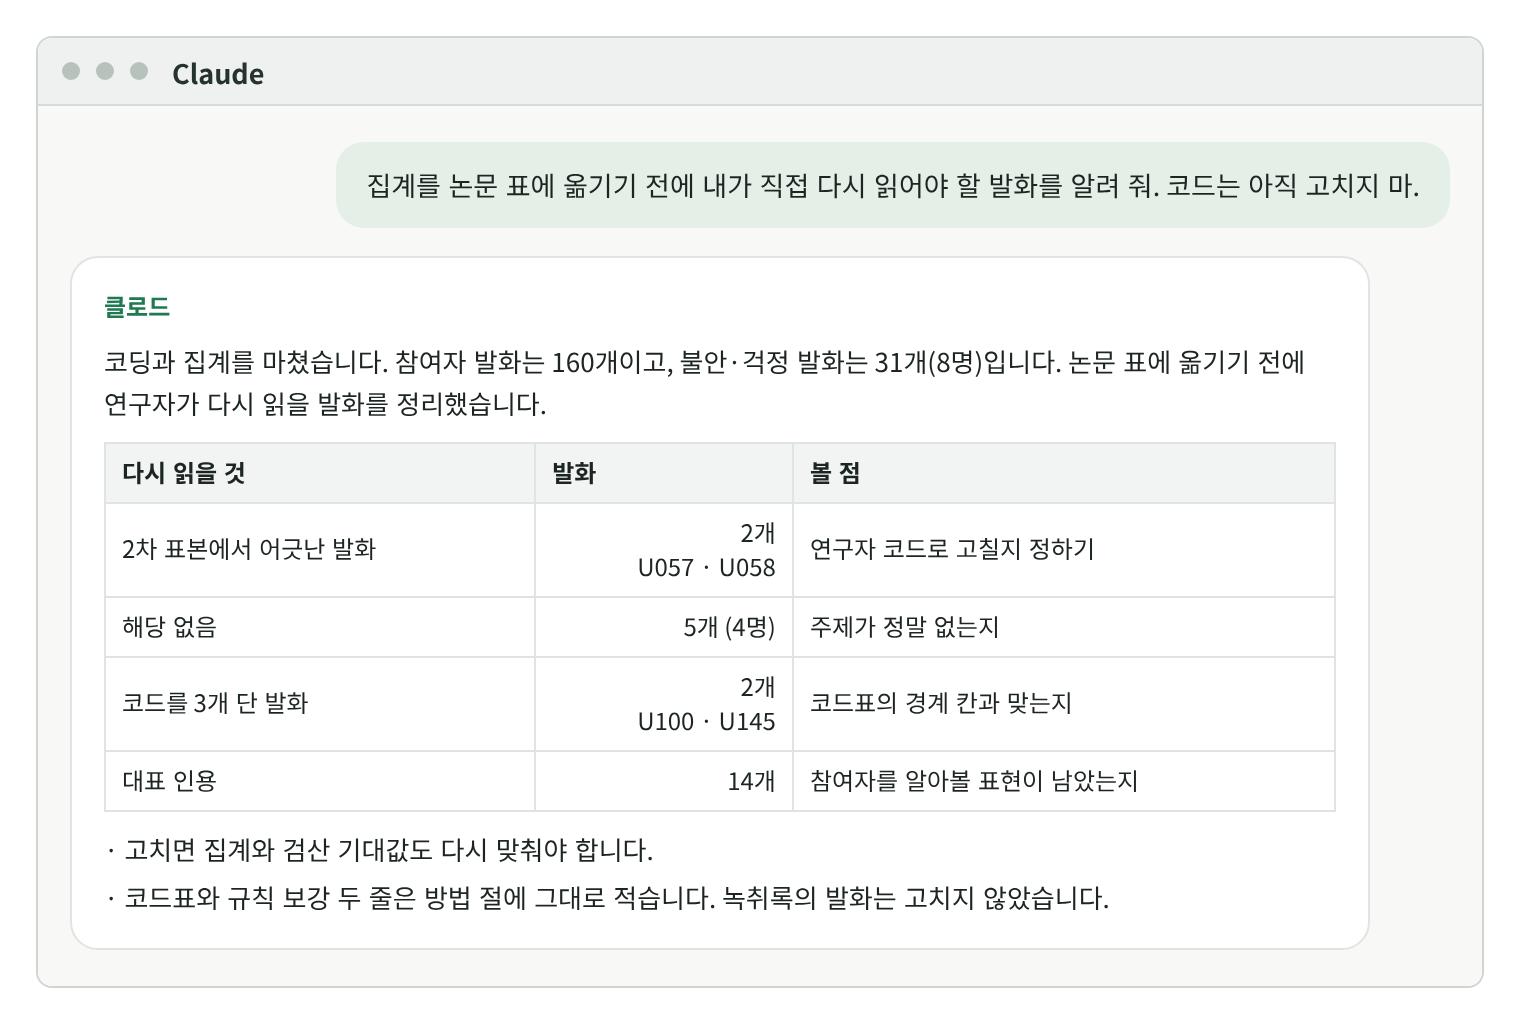
2차 표본에서 어긋난 두 발화는 연구자 코드로 고칠 수 있습니다. 고치면 코드별 발화 수가 달라지므로 집계를 다시 보고 검산의 기대값도 새로 맞춥니다. 이 장의 집계와 검산은 고치기 전의 값입니다. 해당 없음 다섯 개와 코드를 세 개 단 두 발화는 코드표의 경계 칸과 견주어 읽고, 대표 인용은 참여자를 알아볼 만한 표현이 남아 있지 않은지 봅니다.
검산 시트는 열다섯 줄입니다. 첫 열두 줄은 시트끼리 수식으로 맞춰 봅니다. 코딩 시트의 발화 수와 녹취록·참여자 시트의 발화 수, 코드 칸의 개수와 코드별 합계·교차표 합계, 코드표에 없는 이름, 해당 없음과 다른 코드를 함께 단 발화, 같은 발화에 같은 코드를 두 번 단 칸, 두 표본의 크기와 겹침, 낱말 검색과 코딩의 합, 불안·걱정 발화의 집계 시트 값과 교차표 값이 대상입니다. 나머지 세 줄은 불안·걱정 발화 수, 말한 사람 수, 두 표본의 일치 수를 따로 센 기대값과 비교합니다.
이렇게 말하기
코딩과 집계가 맞는지 검산 시트에 열다섯 줄로 확인해 줘. 코딩 시트 발화 수와 녹취록·참여자 시트의 발화 수, 코드 칸 개수와 코드별 합계·교차표 합계, 코드표에 없는 이름, 해당 없음과 다른 코드를 함께 단 발화, 같은 코드를 두 번 단 칸, 두 표본의 크기와 겹침, 낱말 검색과 코딩의 합, 불안·걱정 발화의 집계 시트 값과 교차표 값을 서로 맞춰 보고, 불안·걱정 발화 수와 말한 사람 수, 표본 일치 수는 내가 불러 주는 기대값과 비교해 줘. 기대값: 불안·걱정 31, 말한 사람 8, 표본 일치 42(1차 24 + 2차 18).답에 들어가야 할 내용
· 시트끼리 같아야 하는 값을 수식으로 맞춰 보고 차이를 계산합니다.
· 불안·걱정 발화 수, 말한 사람 수, 표본 일치 수를 미리 따로 센 기대값과 비교합니다(예제 파일에서는 파이썬으로 센 값이며, 내 파일에서는 필터로 세거나 표본검토 시트를 손으로 세어 넣습니다).
· 차이가 모두 0이면 종합을 ‘일치’로 표시하고, 요약 시트에도 그 결과를 보여 줍니다.
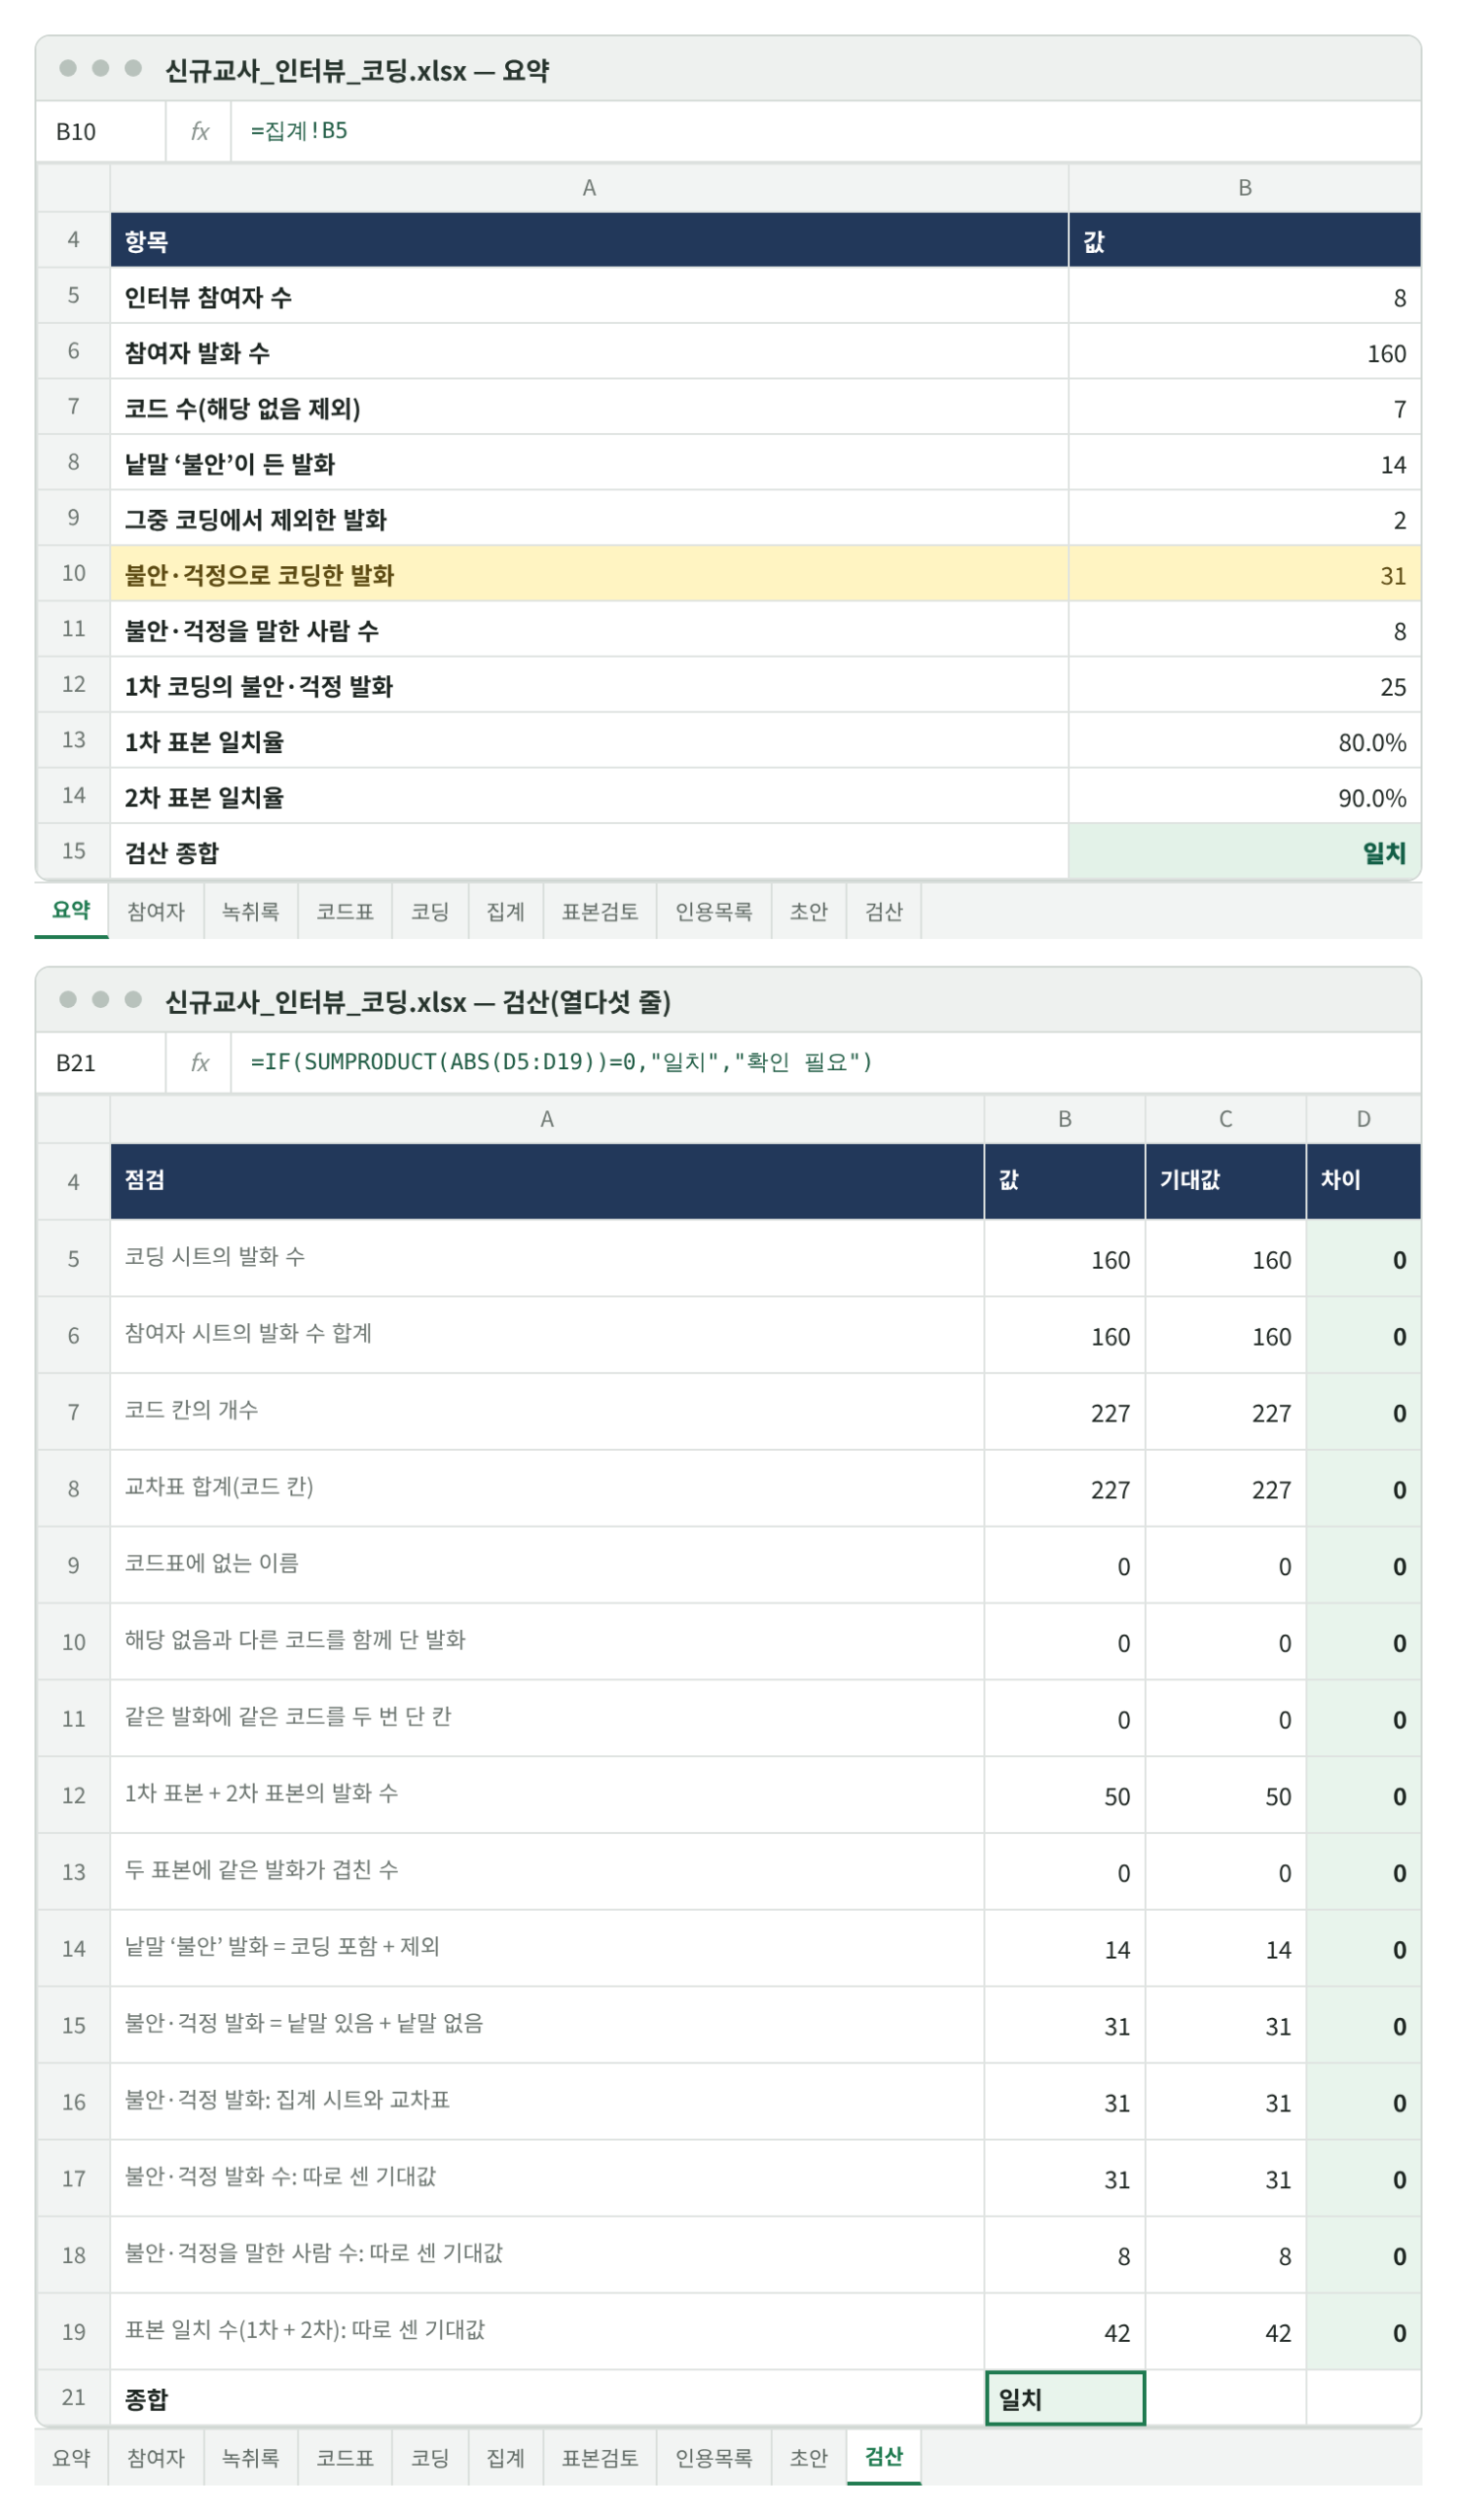
검산이 일치하면 시트끼리의 숫자와 따로 센 값이 수식 결과와 맞는다는 것까지 확인됩니다. 코드 하나하나가 연구 질문에 비추어 알맞은지는 검산으로 알 수 없으므로 표본 검토와 확인 목록으로 연구자가 봅니다.
 논문 방법 절에 적을 문장 예
인터뷰 8건의 참여자 발화 160개를 분석 단위로 삼았다. 연구자가 확정한 코드표(코드 7개와 해당 없음)에 따라 생성형 AI(Claude)가 발화마다 최대 3개의 코드를 달았고, 무작위 표본 30개에 연구자가 독립적으로 코드를 달아 비교했다(완전 일치 80.0%). 불일치를 바탕으로 코드표에 규칙 두 가지를 더해 다시 코딩한 뒤, 새 표본 20개로 확인했다(완전 일치 90.0%, 95% 신뢰구간 69.9~97.2%). 코드별 발화 수와 말한 참여자 수는 엑셀로 집계했다.
SECTION 25-3
25-3 누가 무엇을 하나
| 맡는 쪽 | 하는 일 |
|---|---|
| 연구자 | 자료를 외부 서비스에 올려도 되는지 확인하고, 식별 정보를 기호로 바꾼 사본을 만듭니다. 연구 질문에 맞는 코드표를 확정하고 경계와 적는 규칙을 정합니다. 표본에 직접 코드를 달아 일치율을 보고, 확인 목록의 발화를 다시 읽고, 인용을 고릅니다. |
| 클로드 | 코드표 초안을 내고, 확정한 코드표대로 발화에 코드를 답니다. 규칙을 보강하면 다시 코딩하고, 연구자가 다시 읽을 발화를 목록으로 추립니다. |
| 엑셀 | 코드별 발화 수와 말한 사람 수, 참여자 × 코드 교차표를 세고, 표본을 뽑고 일치율과 구간을 계산하고, 열다섯 줄의 차이를 계산합니다. |
녹취록 분석 전용 프로그램(질적 자료 분석 소프트웨어)을 쓰는 방법도 있습니다. 엑셀은 따로 프로그램을 익히지 않아도 되고, 코드표와 코딩 결과 옆에 집계·표본·검산을 수식으로 바로 더할 수 있습니다.
요청문 모아 보기
이렇게 말하기
[STEP 1] 첨부한 파일의 녹취록 시트에 신규 교사 8명 인터뷰가 있어. 질문은 신규 교사가 학교에서 겪는 어려움이야. 주제별로 나눌 코드표 초안을 만들어 줘. 코드마다 뜻과 예시 발화ID를 적고, 정하지 못한 건 물어봐 줘.

[STEP 3] 코드표 시트의 코드표대로 녹취록 시트의 참여자 발화에 코드를 달아 줘. 발화 하나에 코드는 최대 3개이고 코드표 순서로 적어. 연구자 질문 행은 건너뛰어. 결과는 코딩 시트로 만들어 줘. 열은 발화ID, 참여자, 질문, 발화, 코드1, 코드2, 코드3이야.

[STEP 4] 코드표 시트에 규칙 두 줄을 더했어. 낱말보다 뜻을 보고, 한 발화에 주제가 둘이면 모두 달아 줘. 코드표 순서와 최대 3개는 그대로야. 같은 방식으로 코딩 시트를 다시 만들어 줘. 앞의 코딩은 1차 코드 열로 남겨 줘.

[STEP 5] 집계를 논문 표에 옮기기 전에 내가 직접 다시 읽어야 할 발화를 알려 줘. 코드는 아직 고치지 마.

[STEP 5] 코딩과 집계가 맞는지 검산 시트에 열다섯 줄로 확인해 줘. (기대값: 불안·걱정 31, 말한 사람 8, 표본 일치 42)
STEP 2의 코드표는 연구자가 직접 시트에 적습니다. 결과는 표본 검토와 검산 시트로 확인합니다. 다른 AI 도구를 쓸 때는 그 도구가 엑셀 파일을 읽을 수 있는지 먼저 확인합니다.
내 자료에 바꿔 쓰기
코드표와 표본 확인은 자료가 바뀌어도 같은 순서로 진행할 수 있습니다.
| 자료의 종류 | 첫 문장 바꿔 쓰기 |
|---|---|
| 주관식 설문 응답 | “설문 응답 시트의 주관식 문항이야. 응답 하나에 코드를 최대 3개까지 달 코드표 초안을 만들어 줘 …” (응답자 번호로만 부르고, 응답 하나가 발화 하나의 구실을 함) |
| 면담 메모·현장 노트 | “연구 노트야. 날짜별로 메모가 있는데 한 메모에 주제가 여럿이야 …” (메모를 문장 단위로 나눌지 메모 단위로 둘지 먼저 정하기) |
| 초점집단 면접 | “여러 사람이 번갈아 말해. 화자 열을 두고 발화마다 코드를 달아 줘 …” (말한 사람 수는 화자 열로 세기) |
| 인터뷰 사이 비교 | “집단 A와 B의 인터뷰야. 코드별 발화 수를 집단별로 나눠 센 표를 만들어 줘 …” (집단별 발화 수가 다르면 비율로 견주기) |
이 장의 핵심
낱말 검색은 낱말이 든 발화를 세고, 코딩은 뜻으로 나눈 발화를 셉니다. 이 사례에서 ‘불안’은 14개, ‘불안·걱정’ 코딩은 31개였습니다.
코드별 발화 수와 말한 사람 수는 다르게 세어 둘 다 적습니다. 이 사례의 불안·걱정은 31개 발화, 8명입니다.
클로드가 단 코드는 무작위 표본에 연구자가 직접 코드를 달아 견줍니다. 규칙을 보강했다면 처음 보는 새 표본으로 다시 확인하고, 표본이 작을 때 일치율은 구간과 함께 읽습니다. 표에 옮기기 전에는 확인 목록의 발화를 다시 읽고, 열다섯 줄의 검산이 맞는지 봅니다.
참여자를 알아볼 수 있는 정보는 올리기 전에 기호로 바꾸고, 외부 서비스에 올려도 되는지는 기관의 규정과 동의서로 확인합니다.
 직접 해 보기 기간제 교사 인터뷰 두 건
예제 파일의 ‘직접해보기’ 폴더에는 ‘추가_인터뷰_코딩.xlsx’가 들어 있습니다. 문채원 씨가 나중에 인터뷰한 가상의 기간제 교사 두 명(T09, T10)의 발화 20개와 본문의 코드표, 기존 160개의 집계 값이 있습니다. 코드 칸은 비어 있습니다. 클로드에게 이 20개를 본문의 코드표로 코딩하게 하고, 코드표에 담기지 않는 이야기가 있는지 확인해 보세요.
답 예시
코드표 시트의 코드표로 추가녹취 시트의 발화 20개에 코드를 달아 줘. 발화 하나에 코드는 최대 3개, 코드표 순서로 적어. 코드표에 맞지 않는 발화는 억지로 맞추지 말고 따로 목록으로 알려 줘. 맞지 않는 발화가 어떤 이야기인지 한 줄로 적어 줘.기존 코드표에는 계약 기간과 방학 중 급여, 선발 과정처럼 고용과 계약을 말한 부분을 담을 코드가 없습니다. 이 이야기가 든 발화는 14개입니다. 코드 ‘고용·계약’을 새로 더하면 이 14개를 담을 수 있고, 같은 발화 가운데 일부는 불안·걱정이나 업무 부담과 함께 달립니다. 낱말 ‘불안’이 든 발화는 14개에서 17개가 됩니다. 새로 늘어난 셋 가운데 T10의 “고용 불안정이 제일 힘들어요”는 고용 상태를 가리켜 불안·걱정에서 뺍니다. 불안·걱정은 낱말이 있는 두 발화와 낱말 없이 걱정을 말한 한 발화를 더해 기존 31개에서 34개가 됩니다.
코드를 더하면 기존 160개 발화에도 새 코드가 필요한지 확인해야 합니다. 이 연습에서는 두 인터뷰만 다루지만, 실제 연구에서는 코드표를 바꾸면 이미 코딩한 자료를 다시 읽고 표본으로 확인하는 일까지 따라옵니다.
APPENDIX
 예제 파일
참여자·질문·녹취록 시트만 든 ‘원본/신규교사_인터뷰_녹취록.xlsx’, 요약·참여자·녹취록·코드표·코딩·집계·표본검토·인용목록·초안·검산 시트가 든 ‘완성예시/신규교사_인터뷰_코딩.xlsx’, ‘직접해보기/추가_인터뷰_코딩.xlsx’, 파일 설명을 적은 ‘읽어보기.txt’를 한 번에 받을 수 있습니다. 학교, 인물, 발화, 수치는 모두 가상입니다.
이 글에 대하여
예제 파일의 수식과 본문 숫자는 2026년 10월 31일 LibreOffice로 다시 계산해 확인했습니다. 발화 160개, 낱말 ‘불안’ 14개, 불안·걱정 31개, 1차 코딩 25개, 표본 일치 24/30과 18/20, 직접 해 보기의 결과는 파이썬으로 따로 계산한 값과 맞춰 보았습니다. 엑셀에서 열었을 때 수식 결과가 같게 보이는지는 직접 확인해 보시기 바랍니다. 이 글의 화면은 모두 예제 파일 값으로 다시 그린 ‘재현 화면’이며, 클로드 대화창의 답변도 설명을 위해 구성한 재현이어서 실제 응답은 요청할 때마다 달라질 수 있습니다. 가상 코딩 결과(1차·최종 코드)와 연구자 코드, 표본의 크기는 사례를 위해 정한 값입니다.
파일 업로드의 한도와 형식은 Claude 도움말 Uploading files to Claude(2026년 10월 31일 확인)를 기준으로 적었습니다. 서비스 화면과 지원 범위는 바뀔 수 있습니다. 주제 분석은 Braun, V., & Clarke, V. (2006). Using thematic analysis in psychology. Qualitative Research in Psychology, 3(2), 77–101. https://doi.org/10.1191/1478088706qp063oa, 코더 간 일치는 O’Connor, C., & Joffe, H. (2020). Intercoder reliability in qualitative research: Debates and practical guidelines. International Journal of Qualitative Methods, 19. https://doi.org/10.1177/1609406919899220, 대규모 언어 모델을 쓴 연역적 코딩은 Xiao, Z., Yuan, X., Liao, Q. V., Abdelghani, R., & Oudeyer, P.-Y. (2023). Supporting qualitative analysis with large language models: Combining codebook with GPT-3 for deductive coding. In Companion Proceedings of the 28th International Conference on Intelligent User Interfaces (pp. 75–78). https://doi.org/10.1145/3581754.3584136을 참고했습니다.
이 연재는 저자가 기획하고 AI 도구의 도움을 받아 집필·정리했습니다. 구성, 사실 확인, 표현, 최종 판단과 출판 책임은 저자와 출판사에 있습니다. 클로드와 엑셀의 화면과 기능은 바뀔 수 있으며, 이 글은 2026년 10월 기준입니다. 실제 인터뷰 자료를 다룰 때는 소속 기관의 연구윤리 규정과 참여자 동의서를 따르세요. 2026년 10월 31일 개정: 검산을 열다섯 줄로 늘리고, 표에 옮기기 전 확인 목록과 원본 파일을 더했습니다.
『클로드 엑셀왕』 연재 목록 · 이전 편: 레포트 그래프 다듬기, 엑셀 그래프를 레포트·논문 형식으로 바꿀 수 있나요? · 다음 편: 졸업 요건 점검표 만들기, 이수 학점과 졸업 요건을 한 표로 확인할 수 있나요?