벽에 부딪히는 순간
2부의 모든 노력은 GPU 한 대를 쥐어짜는 일이었다. 배치를 채우고, 캐시를 촘촘히 담고, 짐을 줄이고, 걸음을 줄였다. 그러나 한 대에는 넘을 수 없는 벽이 둘 있다. 하나는 크기의 벽이다. 2장에서 셈했듯 70B 모델의 반정밀도 가중치만 약 140기가바이트다. 사용 가능한 메모리가 이보다 작은 가속기에서는 이 가중치를 한 장에 담을 수 없다. 게다가 가중치가 간신히 들어가더라도, KV 캐시와 실행 중 필요한 버퍼를 위한 공간이 추가로 있어야 한다. 그래서 가중치가 들어간다는 것과 서비스로 운영할 수 있다는 것은 서로 다른 판단이다. 필요한 메모리의 총량이 장치의 가용 용량을 넘으면, 아무리 알뜰하게 써도 모델을 한 장에 담을 수 없다. 다른 하나는 처리량의 벽이다. 요청이 한 대가 감당할 수 있는 양을 넘어 쏟아지면, 한 대를 아무리 잘 다뤄도 밀려드는 요청을 다 받아 낼 수 없다.
두 벽 앞에서 답은 하나로 모인다. 여러 대의 GPU를 함께 쓰는 것이다. 이 장부터 시작되는 3부는 한 대의 한계를 넘어 여러 대로 규모를 키우는 이야기이며, 그 첫걸음이 하나의 모델을 여러 GPU에 나누는 병렬화다.
다만 여러 대를 쓴다는 것이 공짜가 아니라는 점을 처음부터 못박아 두자. GPU들은 서로 데이터를 주고받아야 하고, 그 주고받음에는 시간이 든다. 한 대 안에서의 계산은 빠르지만, 대와 대 사이의 통신은 그보다 느리다. 이 속도 차이가 병렬화의 모든 셈을 지배한다. GPU 안에서 숫자를 옮기는 것과 GPU 사이로 숫자를 옮기는 것은 속도가 크게 다르고, 서버 안의 GPU끼리 옮기는 것과 서버를 건너 옮기는 것 또한 다르다. 통신에도 이렇게 계층이 있어서, 어떤 통신을 어느 계층에 놓느냐가 병렬화 설계의 핵심이 된다. 병렬화의 모든 기술적 고민은 일을 어떻게 나눌 것인가와, 나누느라 생기는 통신을 어떻게 줄일 것인가 사이의 줄다리기다. 이 장은 그 줄다리기의 기본 구도를 그린다. 세부 기법의 이름을 외우는 것이 목적이 아니고, 일을 나누는 방향에 어떤 것들이 있고 각각이 무엇을 대가로 치르는지의 지도를 그리는 것이 목적이다. 그 지도가 있으면 처음 보는 병렬화 설정도 어느 칸에 속하는지 짚어 낼 수 있다.
나누는 두 가지 방식
여러 GPU에 일을 나누는 방식은 크게 두 갈래로 갈린다. 무엇을 나누느냐가 다르다.
첫째는 요청을 나누는 것으로, 데이터 병렬 또는 복제본 병렬(data/replica parallelism)이라 부른다. 모델 전체를 여러 GPU에 각각 통째로 복사해 올려 두고, 들어오는 요청들을 각 GPU에 나눠 보낸다. GPU 하나가 모델 한 벌을 온전히 갖고 독립적으로 일하는 방식이다. 이것은 사실 새로울 것이 없다. 식당을 하나 더 여는 것과 같다. 같은 메뉴를 파는 매장을 여러 개 두고 손님을 분산하는 것이라, 처리량의 벽에는 직접 답이 된다. 다만 크기의 벽에는 무력하다. 매장 하나에 주방이 다 들어가야 하듯, GPU 하나에 모델 한 벌이 다 들어가야 하기 때문이다. 모델이 GPU 한 장보다 크면 이 방식은 애초에 성립하지 않는다. 요청 나누기는 이미 2부의 배칭과 5장의 부하 이야기에서 그 그림자를 보았다. 한 대가 감당 못 하는 부하가 오면 서버를 늘려 요청을 나눈다고 했던 그 이야기가 바로 이것이다. 그래서 요청 나누기는 규모 문제의 낯선 신기술이라기보다, 익숙한 서버 증설의 언어에 가깝다.
둘째는 모델을 나누는 것이다. 하나의 모델을 쪼개어 여러 GPU에 조각조각 나눠 올리는 것이다. GPU 하나는 모델의 일부만 갖고, 여러 GPU가 힘을 합쳐야 비로소 모델 하나가 돌아간다. 이 방식에서는 GPU 여러 장이 물리적으로는 여러 대지만 논리적으로는 한 대의 큰 일꾼처럼 묶여 움직인다. 한 요청을 처리하기 위해 그 안의 여러 GPU가 서로를 기다리고 주고받으며 함께 작동하는 것이다. 이 방식은 크기의 벽을 정면으로 넘는다. 한 장에 안 들어가는 모델도 여러 장에 쪼개어 담으면 되기 때문이다. 이 장에서 병렬화라 부르며 자세히 다루는 것은 주로 이 두 번째, 모델을 나누는 방식이다. 요청을 나누는 방식은 원리가 단순하고 3부의 뒤에서 서빙 시스템의 규모를 다룰 때 자연스럽게 다시 나온다.
모델을 세로로 자르기: 파이프라인 병렬
모델을 나누는 데에도 방향이 있다. 첫 번째 방향은 모델을 세로로, 즉 층의 흐름을 따라 자르는 것으로, 파이프라인 병렬(pipeline parallelism, 줄여서 PP)이라 부른다. 2장에서 모델은 같은 구조의 층을 수십 개 쌓은 것이라고 했다. 이 층들을 몇 덩어리로 나눠 GPU마다 맡기는 것이 세로 자르기의 발상이다. 예를 들어 층이 여든 개인 모델을 GPU 네 장에 나눈다면, 첫 스무 층을 첫 번째 GPU가, 다음 스무 층을 두 번째 GPU가 맡는 식이다. 각 GPU는 모델 전체가 아닌 자기가 맡은 스무 층의 가중치만 메모리에 담으면 되니, 한 장에 안 들어가던 큰 모델도 이렇게 나누면 담을 수 있다. 크기의 벽을 넘는 가장 직관적인 방법인 셈이다.
이 방식의 장점은 통신이 단순하다는 것이다. 각 GPU는 자기가 맡은 층들을 처리한 뒤, 그 결과를 다음 층을 맡은 GPU에 넘기기만 하면 된다. 공장의 컨베이어벨트처럼, 앞 공정이 끝난 반제품을 다음 공정으로 넘기는 것과 같다. GPU 사이에 오가는 데이터는 층과 층 사이를 흐르는 그 벡터뿐이라, 통신량이 상대적으로 적다.
문제는 하나의 일감만 흘릴 때 놀고 있는 GPU가 생긴다는 데 있다. 컨베이어벨트에 반제품을 딱 하나만 올리면, 그 하나가 첫 공정을 지날 때 뒤 공정들은 손을 놓고 기다린다. 마찬가지로 요청 하나만 파이프라인에 넣으면, 어느 순간 한 GPU만 일하고 나머지는 자기 차례를 기다리며 논다. 이렇게 되면 비싼 GPU를 여러 장 두고도 한 번에 한 장만 일하는 셈이 되어, 자원이 크게 낭비된다. 이 낭비를 줄이는 방법은 일감을 잘게 쪼개 벨트에 촘촘히 흘려보내는 것이다. 여러 요청이나 여러 조각을 시차를 두고 연달아 투입하면, 첫 GPU가 두 번째 일감을 처리할 때 두 번째 GPU는 첫 번째 일감을 처리하는 식으로 벨트가 채워진다. 이렇게 여러 조각을 겹쳐 흘리면 각 GPU가 동시에 서로 다른 일감을 처리하게 되어 유휴가 크게 준다. 다만 파이프라인을 처음 채우고 마지막에 비우는 앞뒤 구간에는 여전히 노는 시간이 남는데, 이 남는 유휴를 버블이라 부른다. 벨트를 얼마나 잘 채워 이 버블을 줄이느냐가 이 방향의 핵심 과제다. 다만 벨트를 아무리 잘 채워도 시작과 끝에는 벨트가 덜 찬 구간이 남고, 일감을 잘게 쪼갤수록 조각을 넘기는 통신도 잦아진다. 세로 자르기의 이점인 통신 절약과 벨트를 채우려는 노력이 서로 당기는 관계라, 이 방향에도 공짜는 없다.
모델을 가로로 자르기: 텐서 병렬
두 번째 방향은 모델을 가로로 자르는 것으로, 텐서 병렬(tensor parallelism, 줄여서 TP)이라 부른다. 층의 흐름을 따라 나누는 대신, 각 층 안의 계산 자체를 여러 GPU가 나눠 맡는다. 한 층의 거대한 행렬 곱셈을 여러 조각으로 쪼개어, 각 GPU가 자기 조각을 동시에 계산하고 그 결과를 합치는 방식이다.
이 방식의 장점은 여러 GPU가 같은 층의 계산에 동시에 참여한다는 것이다. 세로 자르기가 GPU들을 단계별로 순서대로 일하게 했다면, 가로 자르기는 같은 순간 모든 GPU가 한 층의 계산에 함께 달려든다. 다만 한 층을 넷이 나눈다고 그 층의 지연이 사분의 일로 줄어드는 것은 아니다. 산술 작업은 대략 네 GPU에 나뉘지만, 조각을 합치는 통신과 커널 효율이 그 이득을 깎기 때문이다. 그래서 모든 GPU가 늘 완전히 활용되지도 않는다. 나눔의 정도를 지나치게 높이면 이 통신 대기가 늘어 오히려 이용률이 떨어질 수 있다. 큰 모델을 여러 GPU로 빠르게 돌리는 데 이 방식이 자주 쓰이는 이유다. 특히 요청 하나의 응답을 빠르게 만들어야 할 때, 즉 지연이 중요할 때 이 방식이 힘을 발휘한다. 한 요청의 계산을 여러 GPU가 동시에 나눠 처리하니 그 요청이 더 빨리 끝나기 때문이다.
대가는 통신이다. 각 GPU가 자기 조각을 계산한 결과는 그 자체로는 반쪽짜리라, 온전한 결과를 얻으려면 GPU들이 서로의 조각을 합쳐야 한다. 그런데 이 합치는 작업이 층마다, 그것도 층 안에서 여러 번 일어난다. 층을 지날 때마다 GPU들이 빈번하게 데이터를 주고받아야 하는 것이다. 세로 자르기의 통신이 공정과 공정 사이에서 이따금 일어났다면, 가로 자르기의 통신은 훨씬 잦고 무겁다. 그래서 이 방식은 GPU들이 아주 빠른 통로로 연결되어 있을 때 제값을 한다. 통로가 느리면 계산을 나눠 얻은 이득을 통신에 다 까먹기 때문이다. 계산을 넷으로 나눠 네 배 빨라지려 했는데 그 사이에 오가는 통신이 계산만큼 시간을 잡아먹으면, 애써 나눈 보람이 사라진다. 그래서 가로 자르기에서는 얼마나 잘게 나누느냐보다 나눈 조각들을 얼마나 빠르게 합치느냐가 실질적인 성패를 가른다. 같은 서버 안에 촘촘히 연결된 GPU들 사이에서 이 방식을 대체로 쓰는 것은 이 때문이다. 모델이 아주 크거나 지연 목표가 빡빡하면 서버 경계를 넘어 이 방식을 적용하기도 하는데, 그때는 통신 비용이 훨씬 민감한 제약이 된다.
두 자르기를 겹쳐 쓰기
세로 자르기와 가로 자르기는 양자택일이 아니다. 실제 대규모 서빙에서는 둘을 겹쳐 쓴다. 이 겹침을 이해하면 큰 모델이 어떻게 수많은 GPU 위에서 돌아가는지의 그림이 잡힌다.
흔한 구도는 이렇다. 아주 빠른 통로로 연결된 한 서버 안의 여러 GPU끼리는 주로 가로로 자른다. 텐서 병렬의 잦은 통신을 감당할 만큼 통로가 빠르기 때문이다. 그리고 그렇게 묶인 서버들 사이는 흔히 세로로 자른다. 서버와 서버 사이의 통로는 상대적으로 느리므로, 통신이 뜸한 파이프라인 병렬을 그 경계에 놓는 것이다. 통신이 잦은 자르기는 빠른 통로 안쪽에, 통신이 뜸한 자르기는 느린 통로 바깥쪽에 두는 이 배치가 자주 쓰인다. 다만 이것은 법칙이 아니라 경향이다. 실제 구성은 GPU들이 어떻게 연결되어 있는지, 모델이 얼마나 큰지, 지연과 처리량 중 무엇을 더 중시하는지에 따라 달라진다.
여기에 앞서 본 요청 나누기까지 얹으면 그림이 완성된다. 모델 한 벌을 여러 GPU에 세로와 가로로 나눠 담아 하나의 완결된 일꾼을 만들고, 그 일꾼을 다시 여러 벌 복제해 요청을 분산한다. 하나를 여러 조각으로 나누는 방향과, 나눈 것을 여럿으로 복제하는 방향이 이렇게 층층이 겹쳐, 거대한 모델이 수백 수천 장의 GPU 위에서 수많은 요청을 감당하게 된다. 이 겹침을 한 문장으로 요약하면 이렇다. 안쪽에서는 텐서 병렬로 한 서버의 GPU들이 한 모델 조각을 함께 계산하고, 그 서버들이 파이프라인 병렬로 이어져 모델 한 벌을 완성하며, 그렇게 만든 완결된 일꾼을 데이터 병렬로 여러 벌 복제해 요청을 나눈다. 잦은 통신은 가장 빠른 안쪽에, 뜸한 통신은 그보다 느린 바깥에 놓는 원칙이 이 층층 구조 전체를 관통한다.
전문가를 나눠 맡기: 전문가 병렬
모델을 나누는 이야기에 최근 하나의 갈래가 더해졌다. 2장에서 일부 파라미터만 골라 쓰는 전문가 혼합 구조를 병렬화 장에서 다시 만난다고 예고했는데, 그 약속을 갚을 자리가 여기다. 이 구조를 서빙할 때의 나눔을 전문가 병렬(expert parallelism, 줄여서 EP)이라 부른다.
전문가 혼합 모델은 전문가를 두는 층, 곧 MoE 층에 여러 개의 전문가를 두고, 토큰마다 그중 일부만 골라 통과시킨다. 모든 층이 이런 구조인 것은 아니고, 일부 층만 전문가를 두고 나머지는 보통의 밀집층인 구성이 흔하다. 전체 파라미터는 매우 크지만, 토큰 하나가 실제로 거치는 파라미터는 그 일부뿐이다. 그래서 이런 모델은 전체 크기에 비해 토큰당 계산이 적다는 독특한 성질을 갖는다. 2장에서 전체 파라미터 수와 실제 계산량이 갈라질 수 있다고 한 그 성질이다.
이 구조를 여러 GPU에 나눌 때는 전문가들을 GPU마다 나눠 맡긴다. 각 GPU가 일부 전문가를 담당하고, 라우터가 각 토큰을 그 토큰이 통과해야 할 전문가가 있는 GPU로 보낸다. 여기서 특유의 어려움이 생긴다. 어느 토큰이 어느 전문가로 갈지는 입력에 따라 달라지므로, 여러 GPU가 서로 토큰을 주고받는 통신이 그때그때 발생한다. 모든 GPU가 서로에게 토큰을 보낼 수 있는 이 통신을 올투올 통신이라 부른다. 게다가 인기 있는 전문가에 토큰이 몰리면 그 GPU의 계산과 통신만 무거워지고 다른 GPU는 노는 부하 불균형이 생긴다. 그래서 전문가 혼합의 서빙은 앞서 본 세로와 가로 자르기에 더해, 토큰을 전문가에게 보내고 그 부하를 고르게 나누는 또 하나의 과제를 안는다.
이 갈래를 여기서 깊이 파지는 않는다. 다만 큰 모델을 나누는 방식이 층을 세로로 자르고 계산을 가로로 자르는 둘에 그치지 않고, 전문가를 나눠 맡기는 방향으로도 확장된다는 점, 그리고 그때 토큰을 실어 나르는 올투올 통신과 부하의 쏠림이 새로운 고민거리가 된다는 점은 지도에 담아 둘 만하다.
나누는 축은 여기서 하나 더 늘어날 수 있다. 지금까지는 모델을 나눴지만, 문맥의 토큰 축 자체를 여러 GPU에 나누는 방향도 있다. 아주 긴 문맥을 다룰 때 각 GPU가 문맥의 일부 구간을 맡는 이 방식은 문맥 병렬이라 불리며, 긴 문맥을 다루는 뒤의 장에서 다시 만난다. 일부 문헌은 시퀀스 병렬이라는 이름도 쓰지만, 그 이름은 문맥 병렬과 구별되는 별도 기법을 가리키기도 하므로 이 책은 문맥 병렬로 부른다. 모델을 나누는 세 방향에 이 문맥을 나누는 방향까지 더하면, 큰 규모의 서빙이 활용하는 나눔의 축이 대략 갖춰진다.
몇 장이 필요한가
병렬화의 감을 굳히려면 간단한 손계산 하나면 된다. 앞서 본 70B 모델을 예로, 반정밀도 가중치가 약 140기가바이트라 하자. 만약 쓸 수 있는 GPU 한 장의 가용 메모리가 80기가바이트라면, 가중치만으로도 두 장이 필요하다. 140을 80으로 나누면 1.75이니, 올림하여 최소 두 장이다.
그런데 이 두 장은 가중치만 담기 위한 산술적 하한일 뿐이다. 실제로는 가중치 외에 KV 캐시와 실행 버퍼가 들어갈 공간이 있어야 하고, 동시에 여러 요청을 받으려면 캐시가 그만큼 더 필요하다. 그래서 실제 운용에 필요한 장수는 이 하한에 KV 캐시와 실행 버퍼, 목표하는 동시 요청 수를 더해 별도로 계산해야 한다. 몇 장이 필요한가라는 물음의 답은 가중치만으로 나오지 않고, 이 요소들을 함께 넣어야 비로소 나온다.
여기서 흔한 오해 하나를 짚어 두자. GPU를 두 배로 늘리면 속도도 두 배가 될 것 같지만, 대체로 그렇게 되지 않는다. 나누는 데에는 통신이라는 대가가 따르고, 나눌수록 그 통신이 늘기 때문이다. 두 장을 네 장으로 늘리면 계산은 더 잘게 나뉘지만 GPU들이 주고받아야 할 통신도 함께 늘어, 얻는 속도가 두 배에 못 미친다. 병렬도를 높일수록 통신이 이득을 갉아먹는 이 체감 때문에, 무작정 GPU를 많이 붙인다고 그만큼 빨라지지는 않는다. 적정한 병렬도를 찾는 것이 그래서 하나의 과제가 된다.
나눔의 저울
이 장을 관통한 것은 나눔의 저울이다. 일을 나누면 크기의 벽과 처리량의 벽을 넘을 수 있지만, 나누는 방식마다 대가가 다르다. 이 네 방향을 무엇을 풀려는가로 갈라 두면 선택이 쉬워진다. 데이터 병렬은 처리량을 늘리려는 것이고, 파이프라인 병렬과 텐서 병렬은 한 장에 안 들어가는 모델을 담으려는 것이며, 그중에서도 텐서 병렬은 한 요청의 응답을 빠르게 만들려 할 때, 즉 지연을 줄이려 할 때 특히 쓰인다. 전문가 병렬은 전문가 혼합이라는 특정 구조를 나눌 때의 방식이다. 요청을 나누면 처리량은 얻되 크기의 벽은 못 넘는다. 모델을 세로로 나누면 통신은 아끼되 GPU가 놀기 쉽다. 모델을 가로로 나누면 GPU를 다 굴리되 통신이 무거워진다. 어느 것도 공짜가 아니며, 그래서 실제 설계는 이 방식들을 하드웨어의 연결 구조에 맞춰 겹쳐 쓴다. 데이터 병렬, 파이프라인 병렬, 텐서 병렬, 전문가 병렬을 한자리에 놓고 견주면 이 갈림이 또렷해진다. 데이터 병렬은 크기의 벽을 못 넘지만 처리량을 늘리고 통신이 적다. 파이프라인 병렬은 크기의 벽을 넘고 통신이 적지만 버블이라는 유휴를 낳는다. 텐서 병렬은 크기의 벽을 넘고 지연을 줄이지만 통신이 잦아 빠른 통로를 요구한다. 전문가 병렬은 전문가 혼합 구조에 한해 큰 모델을 나누되 올투올 통신과 부하 불균형을 안는다. 이 네 칸의 얻음과 지불을 나란히 두는 것이, 처음 보는 병렬화 설정을 읽어 내는 지도가 된다.
이 저울을 손에 쥐면 대규모 서빙의 설명들이 하나의 언어로 읽힌다. 어떤 시스템이 GPU 몇 장을 어떻게 묶었다는 이야기를 들을 때, 그것이 크기의 벽을 넘으려는 것인지 처리량의 벽을 넘으려는 것인지, 어느 통로에 어느 자르기를 놓았는지를 물을 수 있다. 예를 들어 모델은 한 장에 충분히 들어가는데 요청이 밀린다면 답은 데이터 병렬로 복제본을 늘리는 것이고, 모델이 커서 한 장에 안 들어간다면 파이프라인이나 텐서 병렬로 쪼개야 한다. 한 요청의 응답 속도가 급하다면 텐서 병렬 쪽을, 여러 요청을 많이 소화하는 것이 급하다면 데이터 병렬 쪽을 먼저 떠올리게 된다. 무엇이 부족한지를 알면 어느 나눔을 꺼낼지가 따라 나온다. 다음 장은 이 병렬화를 포함해 지금까지 다룬 모든 조각이 하나의 살아 있는 시스템 안에서 어떻게 맞물려 돌아가는지를, 요청 하나가 도착해 응답이 되어 나가기까지의 여정으로 꿰어 본다.
이 장을 나가며
GPU를 여러 장 묶었다는 말이 이제 한 덩어리로 들리지 않는다. 어떤 모델을 여러 GPU에 나눠 서빙한다는 말을 들었을 때 그것이 요청을 나눈 것인지 모델을 나눈 것인지, 모델을 나눴다면 세로인지 가로인지를 구분할 수 있고, 각 방식이 통신과 GPU 활용에서 무엇을 얻고 무엇을 지불하는지를 설명할 수 있다.
셋을 점검하고 넘어가자. 한 대의 GPU가 부딪히는 두 벽은 무엇이며, 요청 나누기와 모델 나누기는 각각 어느 벽에 답이 되는가. 모델을 세로로 자르는 방식과 가로로 자르는 방식은 통신과 GPU 활용에서 각각 무엇을 얻고 무엇을 지불하는가. 통신이 잦은 자르기를 빠른 통로 안쪽에 두는 원칙은 왜 성립하는가. 다음 장은 지금까지의 모든 조각이 하나로 맞물리는 서빙 시스템의 해부로 넘어간다.
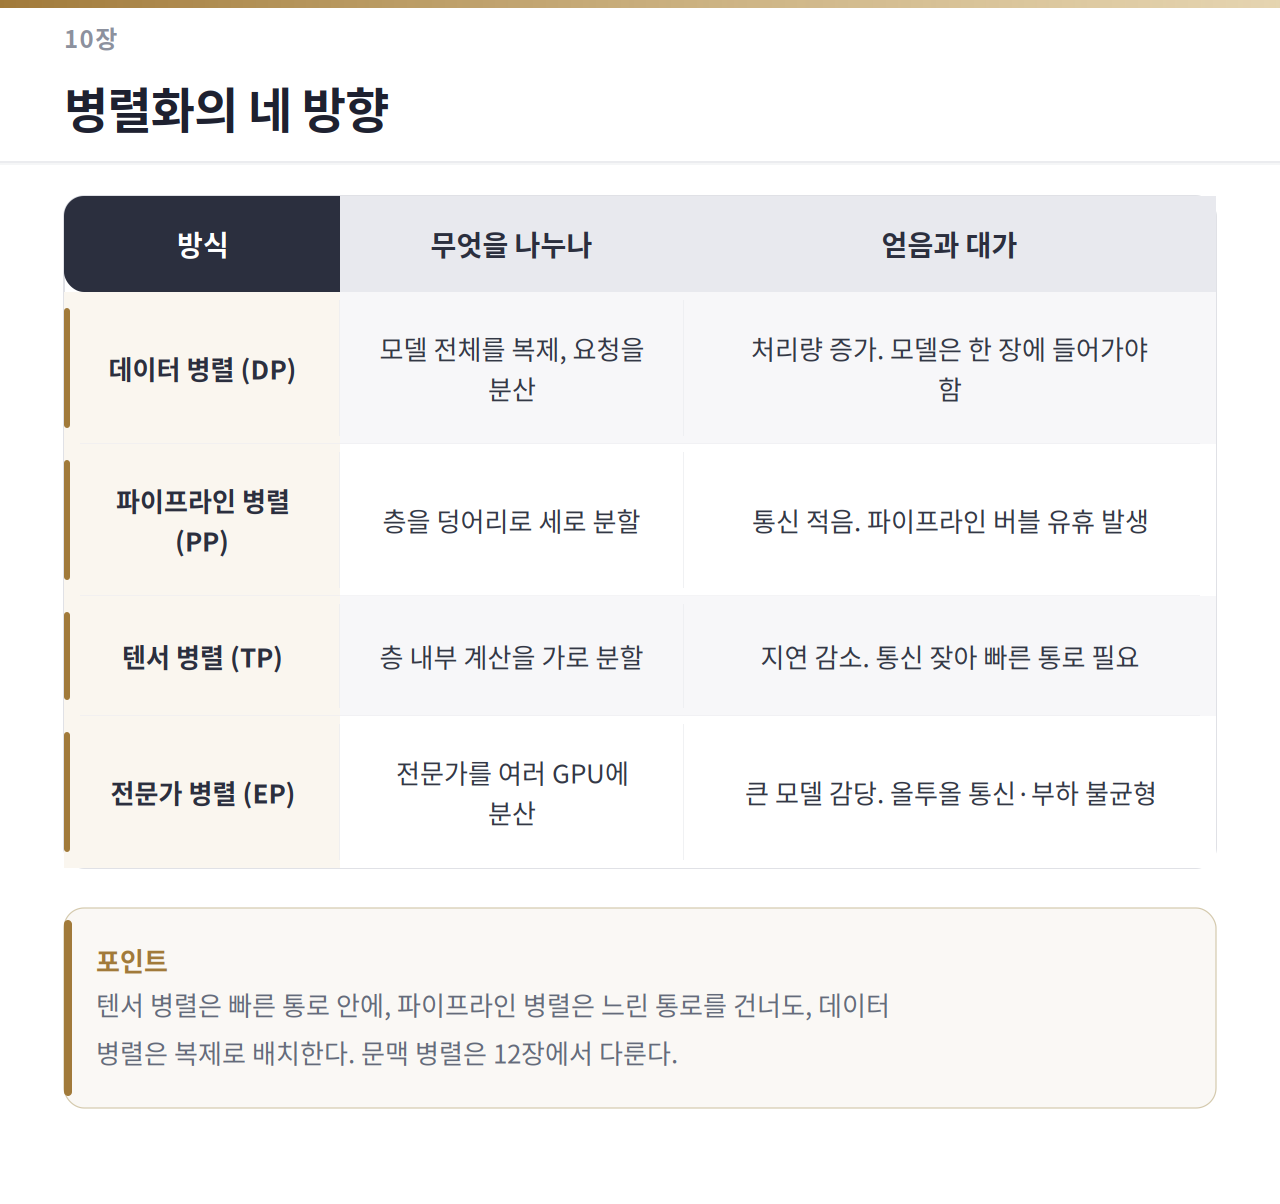
데이터 병렬은 모델을 복제해 요청을 나누고, 파이프라인 병렬은 층을 세로로, 텐서 병렬은 층 내부를 가로로 나누며, 전문가 병렬은 전문가를 분산한다.
그림 10-1. 병렬화의 네 방향