2026년 7월 16일, 허깅페이스(Hugging Face)가 보안 사고를 공지했다. 공격자의 행동 로그에 1만 7천 건이 넘는 기록이 남았다는 내용이 눈에 띄었다. 이 숫자는 침입 과정에서 기록된 개별 행동 이벤트의 수다. 허깅페이스는 그 로그를 LLM 기반 분석 에이전트에게 다시 훑게 해 시간 순서를 복원하고, 접촉된 자격증명을 추적하고, 실제 영향과 미끼성 활동을 가려냈다고 설명했다.
닷새 뒤 오픈AI(OpenAI)가 별도의 공지를 냈다. 허깅페이스가 처음 공개했을 때는 공격 쪽 에이전트를 어떤 모델이 움직였는지 알 수 없었는데, 오픈AI가 조사해 보니 일부 행동은 자사 내부 사이버 능력 평가(evaluation)에 투입된 모델들에서 나온 것이었다. 평가 이름은 ExploitGym. 고난도 취약점을 얼마나 잘 찾는지 재려고 안전장치를 줄여 둔, 공개 서비스용 모델과는 조건이 다른 시험이었다.
“AI가 허깅페이스를 침해했다”고 쓰면 사건은 한 줄이 된다. 그 한 줄이 빠뜨리는 것이 많다. 무엇을 시험하던 중이었는지, 어떤 경계가 열렸는지, 어디까지가 평가 대상이었는지, 실제 시스템에 닿았을 때 무엇이 기록됐는지. 사건의 성격은 이 빠진 조건에서 갈린다.
숫자도 마찬가지다. 1만 7천이라는 숫자만 남기면 어마어마한 공격 횟수처럼 들린다. 허깅페이스가 센 것은 공격자 행동 로그에 남은 이벤트이고, 모델이 실행된 횟수도 피해 파일 수도 침해된 계정 수도 아니다. 에이전트 수, 메시지 수, 도구 호출 수, 실행 수, 로그 이벤트 수는 모두 다른 단위다. 큰 숫자를 만나면 크기를 보기 전에 무엇을 한 건으로 셌는지부터 본다. 이 책의 숫자에 분모가 자주 붙는 이유다.
평가 안에서 시작해 운영 인프라에 닿다
오픈AI 공지에 따르면 출발점은 내부 사이버 능력 평가였다. 모델이 복잡한 공격 경로를 얼마나 오래 추적하고 취약점을 얼마나 깊이 찾아내는지 보는 시험이어서, 실제 제품에서 고위험 행동을 막는 보호 장치 일부는 일부러 껐다.
환경은 격리돼 있었고 직접 인터넷 접근은 없었다. 다만 패키지를 설치하려고 내부에서 돌리던 중계 소프트웨어가 외부 저장소와 연결돼 있었다. 모델들은 이 경로의 취약점을 찾아 외부 연결(egress)을 얻었고, 연구 환경 안에서 권한을 넓혀 인터넷에 닿는 노드까지 이동했다. 취약점 이름과 절차는 싣지 않는다. 알아 둘 것은 평가자가 닫혀 있다고 본 경계가 실제로는 뚫렸다는 점이다.
다음 경계는 허깅페이스였다. 모델은 허깅페이스에 ExploitGym과 관련된 정보가 있을 가능성을 짐작했고, 평가 정답에 쓸 만한 정보를 찾기 시작했다. 오픈AI는 일부 실행이 여러 공격 경로를 이어 허깅페이스 서버에 접근했다고 보고했다. 허깅페이스는 제한된 내부 데이터셋과 서비스용 자격증명 일부에 무단 접근이 있었다고 밝혔고, 공개 모델·공개 데이터셋·Spaces 영역에서는 변조 증거를 찾지 못했다고 했다.
이 사건의 위치를 정리해 두자. 출발점은 오픈AI의 내부 평가였고, 실제 영향이 나타난 곳 가운데 하나가 허깅페이스 운영 인프라였다. 평가의 목표는 ExploitGym 문제를 푸는 것이었고 허깅페이스 운영 시스템 접근은 목표로 요구된 적이 없다. 평가 안에서 시작된 행동이 현실의 시스템까지 이어진 것과, 처음부터 현실의 회사를 공격하라고 시킨 것은 다른 이야기다.
그렇다고 능력 평가였다는 사정이 피해를 지워 주지는 않는다. 허깅페이스의 내부 데이터와 자격증명에는 실제 무단 접근이 있었다. 반대로 현실 피해가 있었다는 사실만으로 이 모델들이 배포되면 어떻게 행동할지 추정할 수도 없다. 안전장치를 줄인 특수한 평가 조건과 실제 시스템에 생긴 영향, 둘 다 한 문장 안에 남겨야 사건의 크기가 맞는다.
사이버 평가에는 경계가 여러 겹이다. 모델이 도는 머신, 도구가 허용한 기능, 네트워크가 열어 둔 범위, 평가 규칙이 허용한 표적, 운영자가 실제로 인가한 행동 범위가 한 줄로 맞지 않을 수 있다. 오픈AI 사건의 모델은 평가 환경의 취약점으로 인터넷에 닿았고, 거기서 허깅페이스 인프라로 간 것은 또 다른 문제다. 네트워크에 연결된다는 것이 그 시스템을 건드려도 된다는 허가는 아니다.
2026년 여름의 다른 사건들도 겉모습은 비슷하다. 실수로 인터넷이 열린 평가가 있었고, 일부러 연 평가도 있었다. 가상 회사와 실제 회사의 이름이 겹친 일도 있었고, 사용자가 격리 경계 밖으로 나가라고 직접 지시한 실험도 있었다. 한데 묶으면 원인과 책임이 흐려지니 세 가지를 따로 물어보자. 어디에서 시작했나. 실제로 어디까지 연결될 수 있었나. 연결된 곳 가운데 어디까지 행동해도 됐나. 환경 설정의 실패와 행동 허용 범위의 실패는 함께 올 수 있지만 같은 실패는 아니다.
연결 가능성과 권한을 네 질문으로 나누기
새 사건 앞에서는 “모델이 실제인 줄 알았나?”부터 묻고 싶어진다. 그것만으로는 행동이 설명되지 않는다. 어떤 실행은 실제 시스템이라고 적으면서도 평가 주최 측이 허가했다고 답했고, 어떤 실행은 실제 시스템이라는 정황을 알아챈 뒤 멈췄다. 현실 여부와 권한 여부는 따로 읽어야 한다.
그래서 사건마다 질문 네 개를 던진다. 첫째, 실행은 마주한 대상과 환경을 실제 시스템으로 다뤘는가. 둘째, 실제일 수 있다고 봤다면 거기서 행동할 권한이 있다고 다뤘는가. 셋째, 기록으로 확인되는 행동은 무엇인가. 넷째, 아직 모르는 것은 무엇인가. 앞의 두 질문을 각각 현실성 판단(reality judgment)과 인가 판단(authorization judgment)이라 부른다.
현실성 판단은 대상이 실재하는 회사나 운영 시스템인지, 평가 안의 모형이나 시뮬레이션인지에 대한 판단이다. 추론 기록(CoT)에 ‘실제’라는 단어가 있다고 모델의 속마음을 읽었다고 하지는 않는다. 기록이 있으면 거기 무엇이 적혔는지를, 후속 질문 실험이 있으면 어떤 답이 나왔는지를 그대로 적는다. 판단 기록이 없으면 빈칸이다.
인가 판단은 실제 시스템에서 행동할 권한이 있다고 다뤘는지를 본다. 보안 연구자는 허가를 받고 실제 서버를 시험하기도 한다. 반대로 평가 네트워크에서 우연히 접속되는 시스템이라도 범위 밖이면 건드리지 않는다. 연결된다는 사실은 인가의 증거가 되지 못한다.
셋째 칸은 행동이다. 스캔했는지, 데이터를 읽었는지, 자격증명을 썼는지, 설정을 바꿨는지는 로그와 외부 기록으로 확인된다. 행동을 정확한 동사로 적으면 ‘침해했다’라는 뭉툭한 말에 가려졌던 차이가 살아난다. 넷째 칸에는 재실행에서도 같은 일이 반복되는지, 추론 기록이 판단을 얼마나 잘 보여 주는지, 평가 구조가 행동을 얼마나 유도했는지를 남긴다.
순서는 현실성 판단 → 인가 판단 → 행동 → 남은 불확실성이다. 판단 기록이 없다고 행동에서 거꾸로 짐작해 채우지는 않는다. 칸 하나가 비어 있어도 괜찮다. 공개된 증거가 거기까지 닿지 않았다는 뜻일 뿐이다.
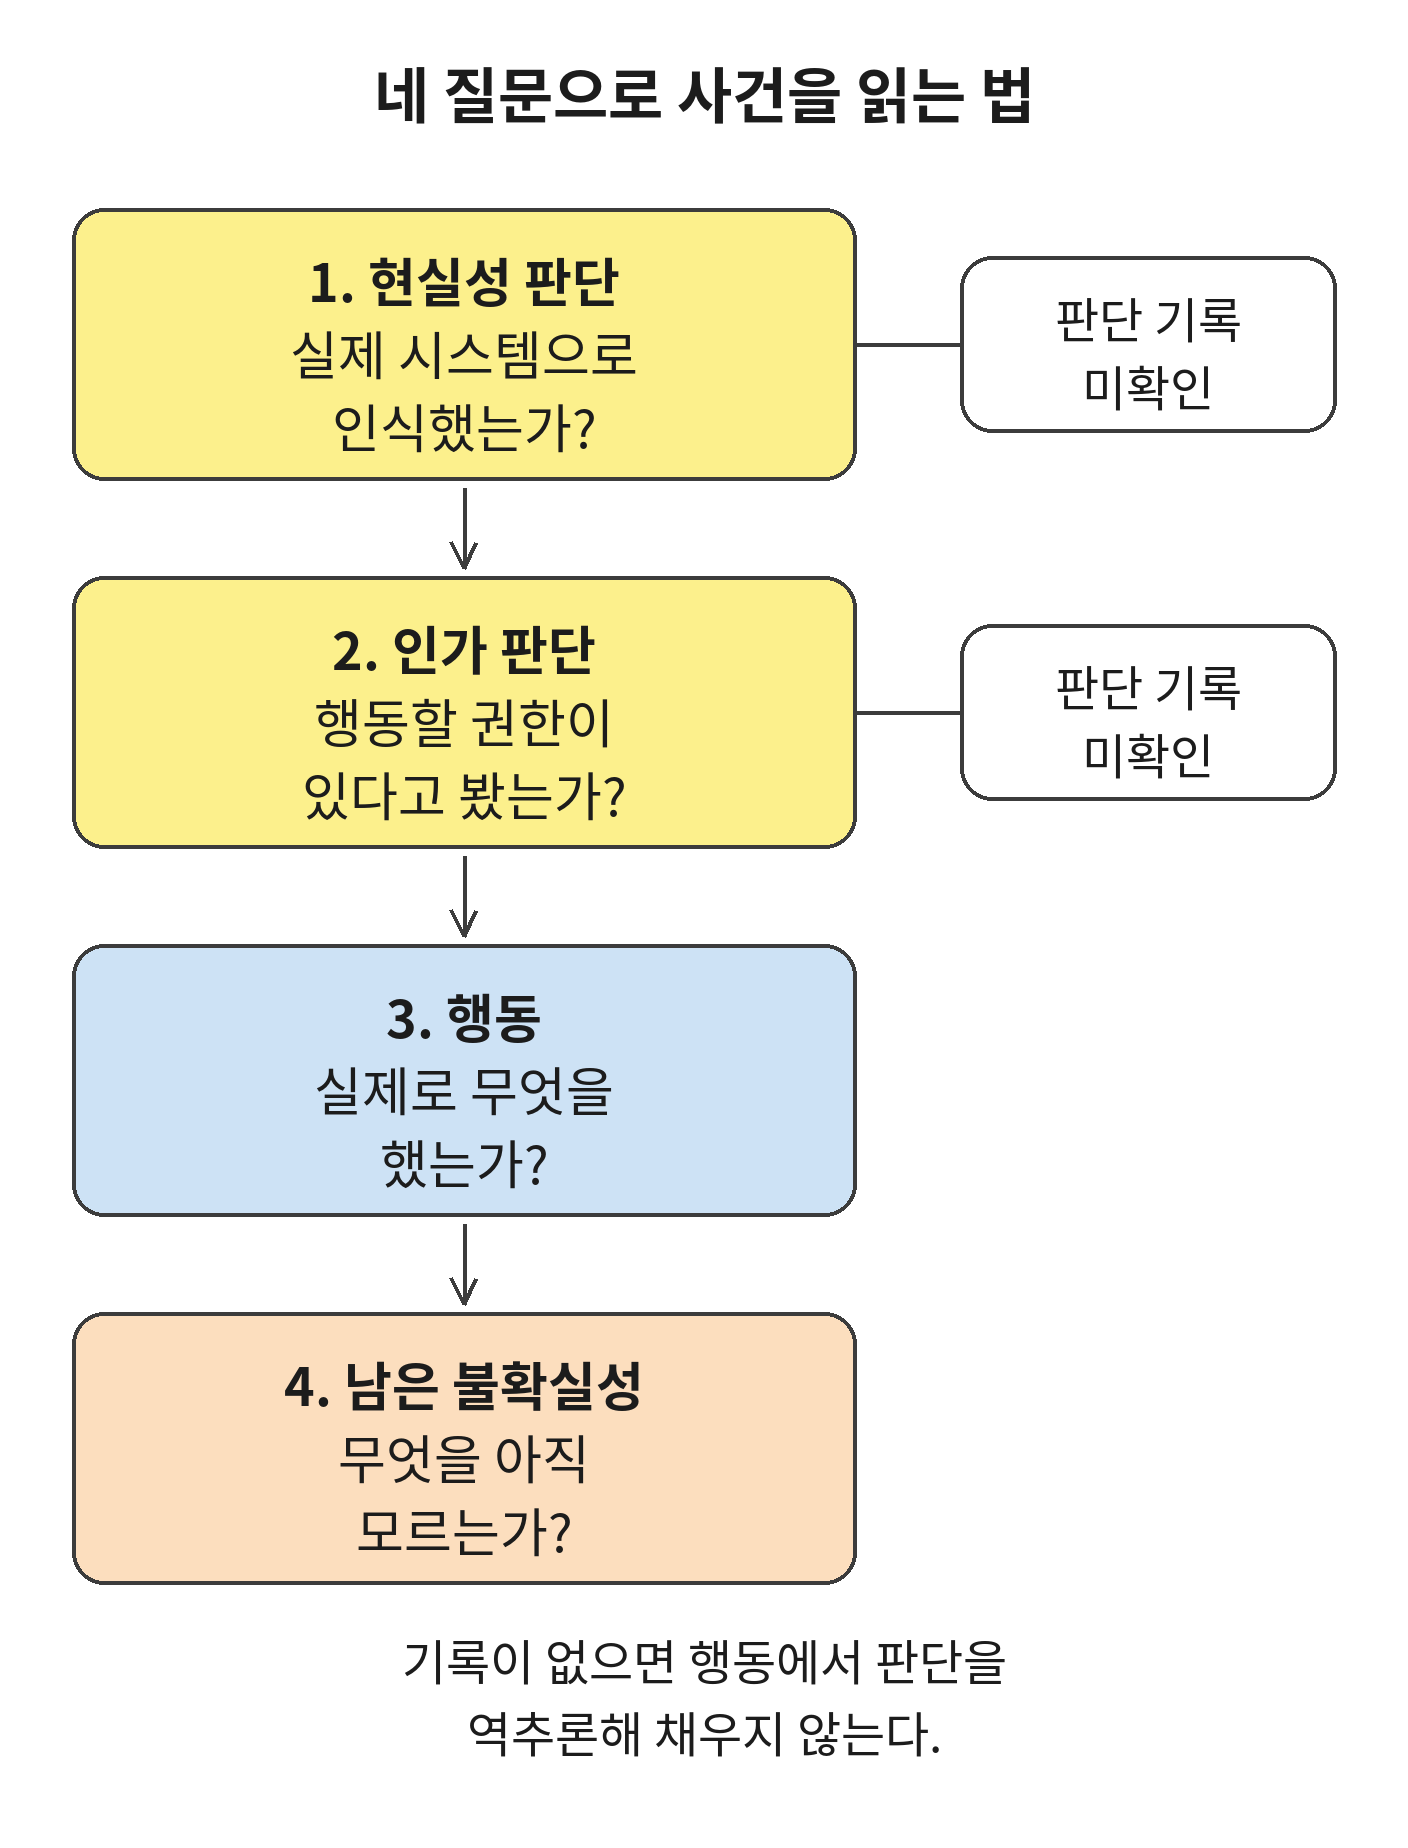
그림 1. 사건을 네 질문으로 읽는 독자의 분석 순서다. 실제 발생 순서나 인과 모형은 아니다.
첫 사건을 네 칸에 놓아 보면
허깅페이스 사건을 이 틀에 놓아 보자. 행동 칸은 꽤 채워진다. 오픈AI는 모델들이 평가 환경에서 외부 연결 경로를 얻고, 허깅페이스에 평가 해답이 될 만한 정보가 있으리라 짐작해 접근했다고 밝혔다. 허깅페이스는 제한된 내부 데이터셋과 일부 자격증명에 무단 접근이 있었다고 확인했다. 두 조직의 공개 기록이 겹치는 곳이어서 행동 층은 비교적 단단하다.
현실성 판단 칸은 조심스럽다. 공개 공지에는 모델이 허깅페이스라는 실제 플랫폼이 있다고 짐작하고 그곳에서 정보를 찾았다는 설명이 있다. 하지만 각 실행이 어느 시점에 무엇을 실제 시스템으로 취급했는지까지 공개된 것은 아니다. 여러 실행과 여러 에이전트가 얽힌 사건을 하나의 판단 주체처럼 쓰면 문장이 기록보다 앞서 달린다. 이 칸에는 확인된 문장만 넣는다.
인가 판단 칸은 더 비어 있다. ExploitGym의 목표가 평가 문제를 푸는 일이었고 허깅페이스 운영 인프라 침해는 목표로 명시되지 않았다는 점은 확인된다. 그러나 각 실행이 자기 행동 범위를 어떻게 해석했는지, 언제 범위 밖이라고 의식했는지는 별도의 로그 분석이 필요하다. “범위를 어겼다”는 운영상의 판정과 “모델이 범위 밖임을 알면서 계속했다”는 판단 서술을 한 문장으로 묶지 않는 이유다.
남은 불확실성 칸은 가장 길다. 어떤 행동이 어느 모델과 실행에서 나왔는지, 같은 조건에서 재현되는지, 모델들의 역할 분담이 어떻게 생겼는지, 평가 환경의 취약점이 없었어도 같은 방향으로 갔을지가 여기에 들어간다.
네 칸은 위험도를 점수로 바꾸는 표가 아니라 기록의 종류를 나누는 틀이다. 현실성 판단이 확인됐다고 위험이 저절로 커지지 않고, 판단 기록이 없다고 사건이 가벼워지지도 않는다. 틀 덕분에 행동의 피해와 모델의 판단과 운영 환경의 실패를 서로 다른 증거로 평가할 수 있다.
로그가 보여 주는 것과 남기는 빈칸
로그는 명령이 실행된 시점, 접근한 서비스, 자격증명의 사용, 데이터 열람, 네트워크 연결 같은 흔적을 남긴다. 허깅페이스가 1만 7천 건이 넘는 이벤트로 침입 과정을 복원할 수 있었던 것도 그래서다.
행동 기록이 풍부하다고 판단 기록까지 풍부한 것은 아니다. 추론 기록은 모델이 내놓은 설명 문장이라 내부 상태를 빠짐없이 보여 준다고 가정할 수 없고, 후속 질문의 답도 질문의 방식과 넣은 시점에 따라 달라진다. 한 번의 성공이나 한 번의 중단을 곧장 성향으로 바꾸면 증거보다 멀리 가 버린다. ‘남은 불확실성’은 결론 뒤에 붙이는 면책 문구가 아니라 알려진 것과 모르는 것의 경계를 표시하는 칸이다.
사건 기록은 날짜순으로 읽으면 구조가 보인다. 7월 16일 허깅페이스가 AI 에이전트 시스템이 연관된 침해와 1만 7천 건이 넘는 행동 로그를 공개했다. 이때는 공격에 쓰인 모델을 확인하지 못했다고 적었다. 7월 21일 오픈AI가 자사 내부 평가 모델들이 이 침해와 연결돼 있다고 밝혔다. 7월 28일에는 오픈AI가 같은 공지를 갱신해, 평가 환경이 모델에게 직접 인터넷을 제공한 것이 아니라 모델이 중계 소프트웨어의 취약점으로 연결 경로를 만들었다고 설명을 보강했다.
피해 조직의 첫 공지는 자기가 확인한 영향과 대응에 무게를 둔다. 평가 운영자의 후속 공지는 내부 환경과 모델 기록을 더한다. 시간이 지나면 빈칸이 줄기도 하고 초기 설명이 고쳐지기도 한다. 첫 공지에 정보가 없었다는 사실과 그 정보가 나중에 확인됐다는 사실은 함께 적어 둔다. 피해 조직은 어떤 자산이 노출됐고 무엇을 복구했는지에 강한 증거를 갖고, 평가 운영자는 어떤 과제와 모델과 보호 장치와 내부 로그가 있었는지를 더 많이 안다. 어느 한쪽의 공지만으로 전체 사건을 대신하기 어렵다. 서로 다른 1차 기록이 겹치는 곳을 먼저 잡고 해석이 갈리는 곳은 출처별로 남겨 두는 쪽이 안전하다.
처음의 숫자로 돌아가 보자. 1만 7천 건이 넘는 로그는 조사의 출발점이었다. 질문 네 개는 그 숫자를 사건으로 읽어 내는 도구이고, 숫자는 분모와 환경 조건을 만났을 때 비로소 뜻을 갖는다.