감사 모델이 짚은 지적 2건은 둘 다 오탐이었다.
9월 22일부터 24일까지, 내 한국어 전자책 한 권을 영어권 독자용으로 다시 쓰는 시험을 했다. 세 회사의 모델에게 초안, 수정, 감사를 하나씩 맡겼다. 초안과 수정은 원고를 실제로 낫게 만들었다. 감사 모델은 일시적인 서버 오류 뒤 다시 실행해 끝까지 돌았지만, 내놓은 지적 두 건이 모두 틀렸다. 원고에 남아 있던 진짜 문제는 그 두 건 속에 없었다. 이 글은 여러 AI 모델에게 역할을 나눠 맡기는 이야기다. 모델을 하나만 쓰는 사람을 위해, 어떤 일을 어느 모델에게 맡기고 어디에 검문을 세우는지 적는다. 고급편의 두 번째 글이다.
2.1 좋은 모델 하나로는 왜 부족한가?
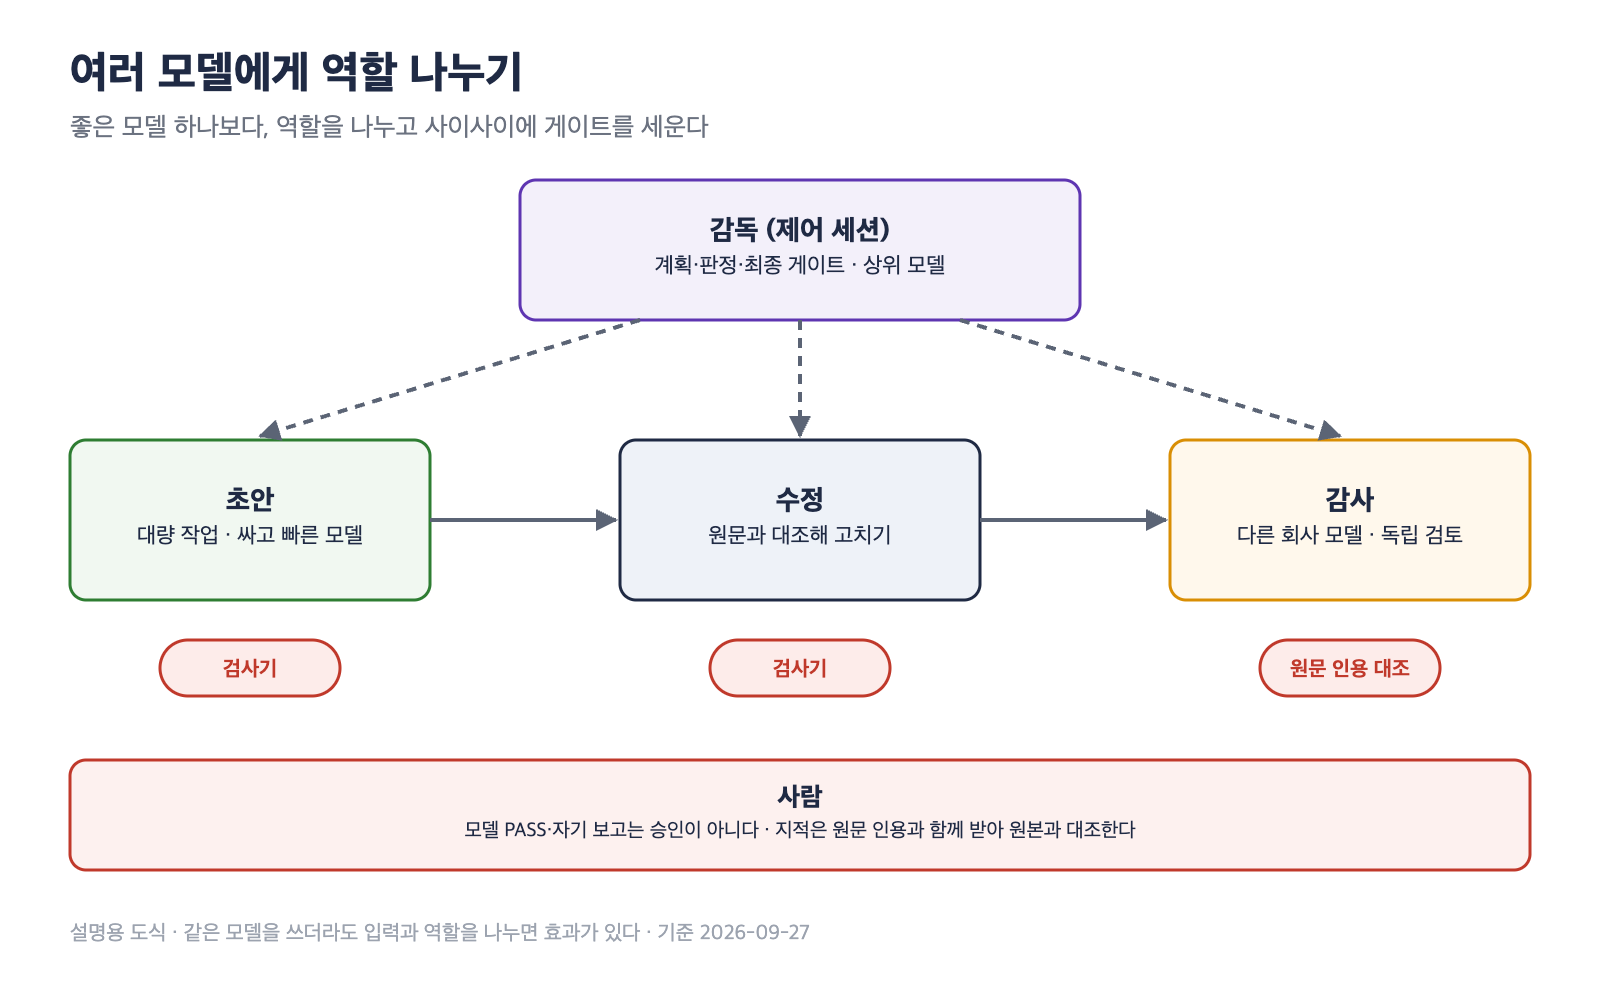
품질은 좋은 모델 하나보다, 역할을 나누고 단계마다 게이트를 세울 때 나온다.
게이트는 다음 단계로 넘어가기 전에 반드시 통과해야 하는 검문이다. 모델 하나에게 쓰기부터 검토까지 전부 맡기면, 같은 모델이 자기 결과를 다시 보게 된다. 그러면 처음 놓친 것을 두 번째에도 놓치기 쉽고, 독립된 감사가 되지 않는다. 역할은 크게 넷으로 나눌 수 있다. 쓰기(초안), 고치기(수정), 감사(독립 점검), 감독(순서를 정하고 최종 판정하는 일)이다. 같은 계열 모델을 여러 자리에 써도 입력과 역할을 나누면 효과가 있다. 쓰는 모델에게는 소재를 주고 대조하는 모델에게는 소재와 초안을 함께 주는 식이다. 다른 회사 모델을 감사자로 두는 것도 도움이 된다. 다만 그 모델의 지적도 주장으로 받고, 원본과 대조해 가린다. 그림 2-1은 이 구조를 그린 것이다.
2.2 Aside의 모델 칸은 무엇을 나눠 두었나?
역할 분리를 처음부터 설계할 필요는 없다. Aside 설정에 이미 그 틀이 있다. Settings > Models 화면 위쪽 Providers에는 모델을 공급하는 곳이 모여 있다. 내 화면에는 Aside(Pro), Claude(Subscription), ChatGPT(Subscription), Grok(Subscription), DeepSeek(API)와 Connect 버튼이 보인다. Aside 요금제, 채팅 서비스 구독, 사용량 과금 API라는 세 가지 연결 방식이 한 화면에 섞여 있다. API는 프로그램끼리 요청을 주고받는 창구이고, 사용량 과금은 쓴 만큼 요금이 붙는 방식이다. 연결하는 경로는 1권 3장에서 다뤘다.
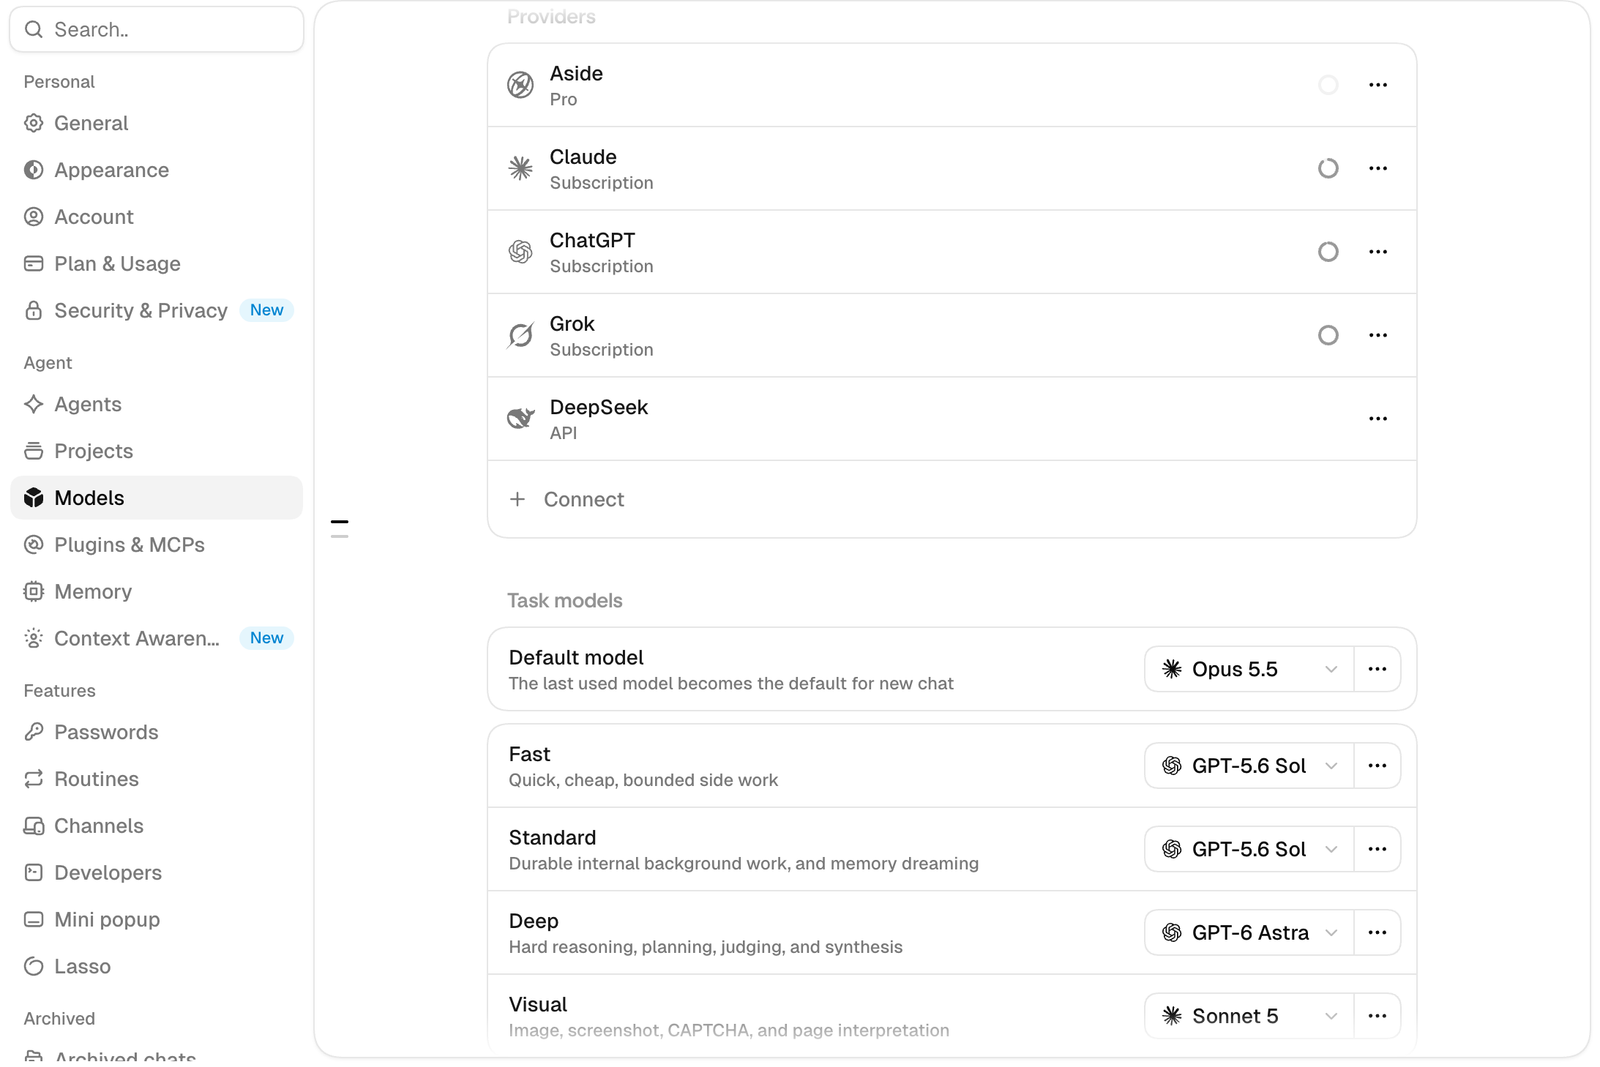
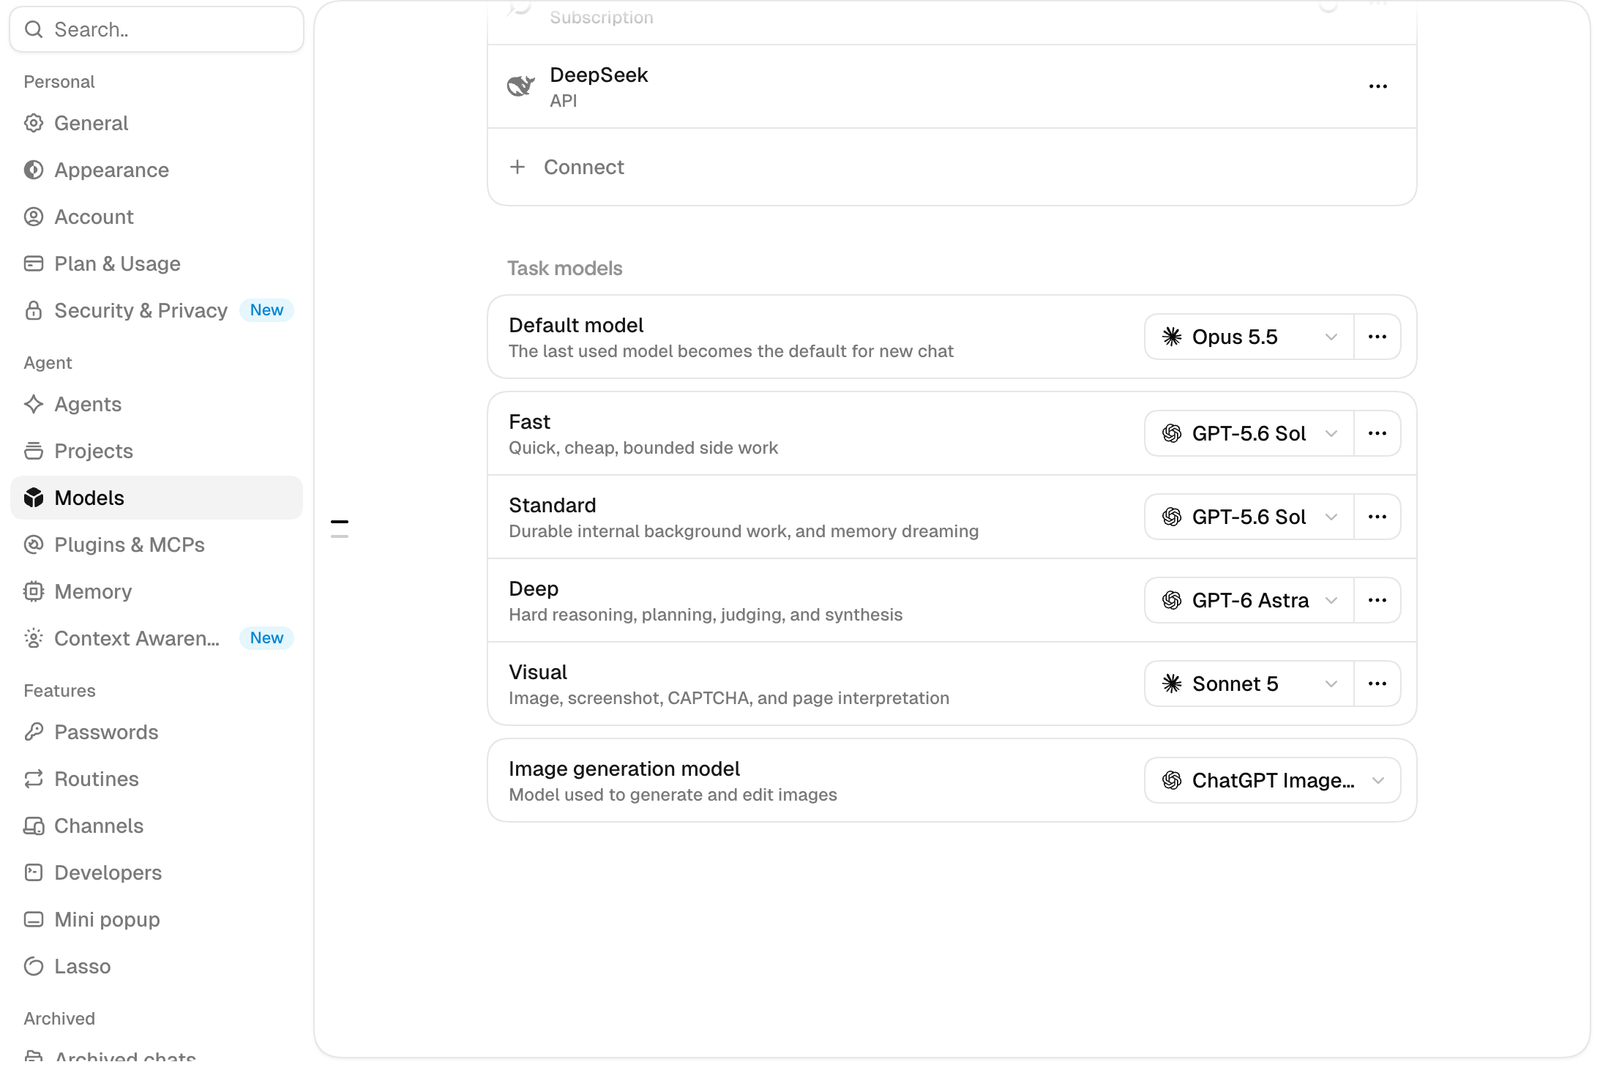
같은 화면 아래쪽 Task models가 이 글의 핵심이다. 일의 종류마다 칸이 있고, 칸마다 모델을 따로 고를 수 있다. Default model은 새 대화의 기본 모델로, 마지막으로 쓴 모델이 기본이 된다고 적혀 있다. Fast는 빠르고 싼 보조 작업, Standard는 오래 걸리는 백그라운드 작업과 기억 정리, Deep은 어려운 추론·계획·판정·종합, Visual은 이미지와 화면 해석을 맡는다. Image generation model은 그림을 만들고 고치는 칸이다. 화면 설명대로라면, 대화에서 고른 모델이 기본이 되고 보조 작업과 판단, 화면 해석은 각 칸의 모델이 맡는다. 표 2-1은 내 화면의 칸과 설명, 설정을 옮긴 것이다.
| 칸 | 화면 설명 | 내 설정 | 어울리는 일 |
|---|---|---|---|
| Default model | The last used model becomes the default for new chat | Opus 5.5 | 대화에서 계획을 세우고 일을 지휘하는 감독 |
| Fast | Quick, cheap, bounded side work | GPT-5.6 Sol | 범위가 정해진 짧은 보조 작업, 진행 확인 |
| Standard | Durable internal background work, and memory dreaming | GPT-5.6 Sol | 오래 걸리는 백그라운드 작업, 기억 정리 |
| Deep | Hard reasoning, planning, judging, and synthesis | GPT-6 Astra | 어려운 판단, 판정, 여러 결과의 종합 |
| Visual | Image, screenshot, CAPTCHA, and page interpretation | Sonnet 5 | 캡처와 화면 읽기 |
| Image generation model | Model used to generate and edit images | ChatGPT Image | 그림 만들기와 고치기 |
표 2-1을 보면 모델을 하나만 쓴다고 생각하는 사람도 이미 여러 모델을 거치고 있을 수 있다. 화면 설명대로라면, 대화 창에서는 Default 칸의 모델과 이야기하지만 짧은 보조 작업은 Fast 칸, 백그라운드 작업은 Standard 칸, 어려운 판정은 Deep 칸, 캡처 읽기는 Visual 칸의 모델이 맡는다. 칸마다 설명이 다른 것은 일의 성격이 다르기 때문이다. 빠르고 싸야 하는 일과 오래 붙들고 따져야 하는 일을 한 모델이 똑같이 잘하기는 어렵다. 이 칸 구성이 바로 쓰기, 고치기, 감사, 감독을 나누는 사고방식과 닮아 있다. 다만 칸은 도구가 정한 일의 종류이고, 내 원고에서 누가 쓰고 누가 검사할지는 따로 정해야 한다.
기본 모델은 대화 안에서도 바꿀 수 있다. 연재 도중 쓰던 모델의 사용 한도가 거의 차서, 대화에서 말로 요청해 다른 모델로 바꾼 적이 있다. 칸이 있다는 것과 그 칸을 역할에 맞게 채우는 것은 별개의 일이다. 그다음은 사람이 정한다.
2.3 이 연재를 만든 역할 분리
이 연재도 역할을 나눠 만들었다. 1권 6장부터 각 장의 초안은 하위 에이전트로 띄운 모델이 썼다. 하위 에이전트는 주 대화(부모 세션)가 따로 띄워 일 하나를 맡기는 작업자다. 부모 세션은 초안을 사실 목록과 대조해 고친 뒤 발행했다. 초안과 대조를 같은 계열 모델이 맡은 때도 있었다. 그래도 입력과 역할은 갈랐다. 초안 모델은 사실 목록을 받아 썼고, 부모는 사실 목록과 초안을 나란히 놓고 대조했다. 초안 모델에게는 사실 목록 밖이라고 판단한 문장을 스스로 보고하라고 시켰지만, 발행 판단은 이 자기 보고에 기대지 않았다. 부모가 문장 단위로 다시 대조했다. 1인칭 문체를 시키면 초안 모델은 식사, 산소 방문, 하루 리듬 같은 장면을 지어 넣었다. “나는 인증을 이렇게 설계한다” 같은 저자의 규칙까지 만들어 냈다.
부모의 대조에서 실제로 고친 예도 있다. 14장 초안은 이용약관의 금지 목록을 “Aside가 해서는 안 되는 일”로 썼는데, 원래 뜻은 “사용자가 Aside로 해서는 안 되는 일”이었다. 같은 초안은 캡처에 가상 값을 넣었다고 적었지만 사실은 바꾸지 않았다. 8장 초안에는 “세 곳에 6건씩” 같은 과장과 근거 없는 단정이 있었다. 모두 문장 하나씩 대조해서 잡았다. 검증 방법은 1권 13장에서 더 자세히 적었다.
2.4 세 모델 파일럿에서 무엇이 드러났나?
도입의 시험으로 돌아가 보자. 직역하지 않고 영어권 독자에게 맞게 다시 쓰는 개작이었고, 표본 항목 세 개로 문체와 편집 비용을 먼저 확인하기로 했다. 파일럿은 본 작업 전에 작게 돌려 보는 시험이다. 명령줄 AI 도구 안에서 세 회사의 모델을 나눠 썼다. 초안 모델이 영어 초안을 쓰고, 수정 모델이 한국어 원문과 대조해 고치고, 감사 모델이 따로 감사했다. 실행은 내 터미널에서 스크립트 한 줄로 했다. 고급편 1편에서 다룬 방식이다.
결과를 원본과 맞춰 보니 통과 표시와 실제 품질이 달랐다. 구조 검사는 PASS였다. 그런데 원고에는 영어권 독자에게 한국어 원어민처럼 말을 거는 문장, 한 문화에 대한 절대적인 주장, 로마자 표기 오류가 남아 있었다. 감사 모델의 지적 두 건은 모두 오탐이었고, 수정 모델의 자기 보고에도 실제 결과와 어긋나는 대목이 여러 곳 나왔다. 그래서 규칙을 정했다. 모델의 PASS, 구조 검사의 PASS, 모델의 자기 보고는 문장 품질을 승인하는 근거가 되지 못한다. 지적에는 정확한 한국어와 영어 인용을 붙이게 하고, 그 인용을 원본 파일과 대조한다.
구조도 고쳤다. 표기 기준표와 표제어 목록을 잠가, 다른 지침과 부딪치면 이 두 파일이 이기게 했다. 스크립트를 다시 돌리면 사람이 승인한 원고를 덮어쓰는 구조도 찾아서, 모델의 출력은 별도 파일에만 쓰게 바꿨다. 전권으로 넓히기 전에 2차 파일럿이 필요하다고 보았고, 아직 전권은 돌리지 않았다. 역할 배정은 품질 밖의 문제에도 닿는다. 이 해외 전자책 판매 플랫폼의 정책에서는 AI가 번역문 자체를 만들면 사람이 많이 고쳐도 ‘AI 생성 번역’으로 신고해야 한다. 사람이 번역하고 AI를 교정과 오류 확인에만 쓰면 신고 대상이 아니다. 누가 쓰고 누가 고쳤는지가 신고 여부까지 바꾼다.
2.5 역할을 나누는 기준
9월 17일과 18일에는 장문 전자책을 쓸 때 여러 모델을 어떻게 배정할지 검토하고, 연결 시험까지 했다. 기본안은 세 층이다. 싸고 빠른 사용량 과금 API 모델에게는 초고, 보강, 문체 정리 같은 대량 작업을 준다. 다른 회사 모델에게는 구조와 문체, 앞뒤 연결을 독립적으로 감사하게 한다. 가장 강한 모델은 감독과 판정, 최종 게이트를 맡는다. 가장 비싼 설정은 전권의 기본값으로 쓰지 않고, 어려운 장에서 비교해 볼 후보로만 둔다. 품질이 모델 교체로 보장되지 않는다는 점도 이 검토에서 확인했다. 한 책을 여러 감사가 나란히 본 적이 있는데, 실제 오류를 많이 찾았지만 빈칸을 출간 차단 사유로 본 오탐, 심각도 과장, 감사끼리 엇갈린 판단도 함께 나왔다. 최종 판정에는 원문을 다시 대조해야 했다.
그래서 비싼 모델을 전권에 되풀이해 넣기보다 검증을 역할별로 나눴다. 표 2-2는 그 기준이다. 오른쪽 칸이 가장 중요하다. 어느 자리의 모델이든 결과를 믿기 전에 사람이나 검사 프로그램이 따로 확인할 것이 있다.
| 역할 | 맡길 일 | 어떤 모델 | 결과를 믿기 전 확인할 것 |
|---|---|---|---|
| 쓰기(초안) | 초고, 보강, 문체 정리 같은 대량 작업 | 싸고 빠른 모델 | 소재 목록 밖의 장면·숫자·규칙이 들어갔는지 문장 단위 대조. 자기 보고만 믿지 않기 |
| 고치기(수정) | 원문과 대조한 수정, 통독, 문법·중복·산술·수치 일치 | 싼 모델, 또는 초안과 입력을 달리한 모델 | 자기 보고와 실제 결과가 맞는지. 작은 수정은 정확한 위치만 고치고 검사기로 확인 |
| 감사(독립 점검) | 구조, 문체, 앞뒤 연결 점검 | 다른 회사 모델 | 지적마다 원문 인용이 붙었는지, 그 인용이 원본 파일에 있는지. 오탐·심각도 과장 가리기 |
| 감독(판정) | 순서 제어, 최신 통계·출처·인과 판단, 법률·저작권, 최종 출간 판정 | 가장 강한 모델 + 자동 검사 | PASS를 품질 승인으로 읽지 않기. 확인한 범위와 대조한 원문이 남았는지 |
표의 경계선은 비용과 위험으로 그었다. 초고, 통독, 문법과 중복 확인, 산술과 수치 일치는 양이 많고 결과를 기계적으로 검사하기 쉽다. 틀려도 검사기나 다음 단계에서 잡힌다. 그래서 싼 모델에게 넘긴다. 반대로 최신 통계와 출처, 원인과 결과를 잇는 판단, 법률과 저작권, 최종 출간 판정은 틀렸을 때 되돌리기 어렵고, 겉보기 문장만으로는 맞는지 알기 어렵다. 이 일은 자동 검사를 먼저 돌리고 상위 모델이 정밀하게 검증한다. 비싼 모델은 모든 문장에 쓰기보다 이 좁은 구간에 모아 쓴다. 모델을 하나만 쓰는 사람이라면, 먼저 자기 작업을 이 두 묶음으로 갈라 보는 것에서 시작할 수 있다.
2.6 감독 모델은 어디에 둬야 하나?
배정 검토에서 가장 중요했던 구분은 감독의 자리다. Aside에서는 대화에서 고른 모델이 기본 모델이 된다. 비용을 아끼려고 싼 모델을 기본(대화) 모델로 고르면, 그 싼 모델이 작업 전체의 계획자가 된다. 계획을 세운 모델이 일꾼을 부르고 결과까지 검토하니, 같은 모델이 자기 결과를 검토하는 셈이다. 그러면 독립 감사가 성립하지 않는다. 순서는 반대로 잡아야 한다. 상위 모델을 제어하는 세션에 두고, 싼 모델은 일꾼으로 불러 쓴다. 표 2-1로 말하면 Default 칸에 감독을 두고, 대량 작업은 따로 불러 맡기는 구조다. 모델을 하나만 쓰던 사람이 두 번째 모델을 들일 때 가장 먼저 정할 것이 이 자리다.
하나 더 구분할 것이 있다. 모델 연결, 역할 배정, 검토 시점은 서로 다른 세 가지다. Providers에 제공자를 연결한다고 역할이 생기지 않고, 역할을 정한다고 검문이 저절로 생기지도 않는다. 게이트는 강제해야 한다. 진행 상태를 적는 파일과 정해진 검사 프로그램을 두고, 단계마다 검사를 통과해야 다음으로 넘어가게 한다. 감독 모델이 “이번에는 검사를 해야지” 하고 기억하는 데 맡기지 않는다. 파일과 검사 프로그램은 매번 같은 기준으로 돈다.
2.7 “문제 없음”도 증거로 받는다
감사 모델이 “문제 없음”이라고 답해도 그대로 통과시키지 않는다. 증거가 없는 통과는 확인하지 않은 것과 구별이 안 된다. 그래서 확인한 문단과 표의 수, 숫자를 다시 계산한 식, 대조한 원문을 함께 남기게 한다. 지적이 있을 때도 같다. 인용이 붙어 있어야 그 문장이 원본에 정말 있는지 찾아볼 수 있다. 작은 수정에도 규칙이 있다. 모델에게 전문을 다시 쓰게 하지 않고, 고칠 위치만 정확히 고친 뒤 검사기로 확인한다.
다른 회사 모델의 감사가 유용하다는 것과 그 감사를 믿는 것은 별개다. 영어판 파일럿에서 받은 다른 외부 검토는 주요 위험을 맞게 짚었지만, 정당한 현지화를 오류로 분류한 대목도 있었다. 원본 파일과 대조해 가렸다. 사이트 점검을 다른 채팅 AI들에게 맡겼을 때도 정확도는 매번 달랐다. 처음 여섯 번은 절반가량이 틀렸고, 틀린 지적이 0건인 적도 있었다. 어느 모델이 감사하든 그 지적은 주장이고, 판정은 원본과 대조한 뒤에 내린다.
2.8 역할을 적은 요청 예시
모델을 여러 개 연결하지 않았더라도, 요청에 역할을 적는 것부터 시작할 수 있다. 요청에 담을 것은 네 가지다. 누가 무엇을 쓰고 고치고 감사하는지, 각자 무엇을 입력으로 받는지, 지적에 어떤 증거를 붙일지, 최종 판정을 누가 하는지다. 아래는 설명을 위해 만든 가상의 요청이다.
[가상 설정]
블로그 글 한 편을 세 단계로 나눠 진행해 줘. 너는 감독만 맡아.

1. 초안: 싼 모델을 하위 작업으로 불러, 첨부한 사실 목록만으로 초안을 쓰게 해 줘.
   사실 목록 밖이라고 판단한 문장은 따로 표시하게 해 줘.
2. 수정: 초안과 사실 목록을 나란히 주고, 목록에 없는 문장을 고치게 해 줘.
   고친 곳만 바꾸고 전문을 다시 쓰지는 말게 해 줘.
3. 감사: 다른 회사 모델에게 수정본을 주고 문제를 찾게 해 줘.
   지적마다 원고의 해당 문장을 그대로 인용하게 해 줘.
   "문제 없음"이면 몇 문단을 확인했는지 적게 해 줘.
4. 감사 지적은 바로 반영하지 말고, 인용이 원고에 실제로 있는지 먼저 대조해 줘.
5. 각 단계의 결과는 별도 파일로 남기고, 내가 승인한 원고는 덮어쓰지 마.
6. 마지막에 반영한 지적과 버린 지적을 이유와 함께 표로 보여 줘.
4번과 6번이 게이트다. 감사 지적을 곧장 반영하면 오탐까지 원고에 들어간다. 버린 지적과 그 이유를 표로 받아 두면, 감독이 무엇을 근거로 판정했는지 나중에 다시 볼 수 있다.
2.9 다음 편: 토큰과 비용 관리
역할을 나누면 비용 문제가 따라온다. 사용량 과금 API 모델은 연결과 기능 시험까지 했지만, 원고 규모로 돌리는 일은 과금 확인 문제로 보류 중이다. 월정액 구독 한도 안에서 쓰면 한 권을 더 쓰는 현금 비용이 0일 수 있다는 견적도 냈다. 9월 26일 밤 Aside 크레딧 표시가 “Pro 0% remaining”이었는데도 연재 작업에 영향이 없던 이유도 다음 편에서 다룬다.
이 글의 확인 범위
기능 설명은 2026년 9월 27일에 확인한 Aside의 모델 도움말과 같은 날 내 Settings > Models 화면을 기준으로 했다. 이후 화면 이름이나 동작은 바뀔 수 있다.
- Task models 칸의 설명은 화면 문구를 옮긴 것이다. Aside 내부에서 정확히 언제 어느 칸의 모델을 쓰는지는 확인하지 않았다. 표 2-1의 ‘어울리는 일’은 화면 설명을 바탕으로 한 내 정리다.
- 표 2-1의 모델 이름은 2026년 9월 27일 내 설정이며 권장값이 아니다. 제공자와 모델 이름은 화면 설명에만 적었고, 내 작업 사례에서는 역할 이름으로 불렀다.
- 세 모델 파일럿은 9월 22~24일, 표본 항목 세 개로 한 시험이다. 전권에는 아직 적용하지 않았고 2차 파일럿이 남아 있다. 도서명, 판매 플랫폼명, 명령줄 도구 이름은 적지 않았다.
- AI 생성 번역 신고 기준은 내가 확인한 한 해외 전자책 판매 플랫폼의 정책이다. 다른 플랫폼은 기준이 다를 수 있다.
- 표 2-2의 배정 기준은 9월 17~18일 검토와 연결 시험에서 정한 설계다. 사용량 과금 API 모델의 원고 규모 운영은 보류 중이며, 구독 한도 안의 현금 비용 0은 견적 판단이고 실측이 아니다.
- 외부 AI 점검의 정확도(처음 여섯 번 절반가량 틀림, 0건 틀린 적도 있음)는 내 사이트 점검 기록 기준이다.
- 역할을 나눠도 결과를 검증 없이 믿어도 된다는 뜻은 아니다. 최종 판정은 원본 대조와 사람의 몫이다.
- 그림 2-1은 설명용 도식이다. 그림 2-2와 2-3은 실제 화면이며 설정값은 바꾸지 않았다. 2.8절의 요청은 가상이다.
참고한 자료
2026년 9월 27일 확인. 모델과 AI 도움말
다음 글: 고급 활용 3 · 토큰과 비용 관리
이전 글: 고급 활용 1 · 명령어를 몰라도 CLI의 장점을 쓰는 법
1권: 『Aside 브라우저 사용설명서』 연재 목록
『Aside 고급 활용』 연재 목록
저자의 실제 사용 경험과 Aside 도움말을 바탕으로 AI의 도움을 받아 작성·편집했습니다. 초판 선공개 원고 v1.0.